无字母版有声音,字幕仍需重新整理
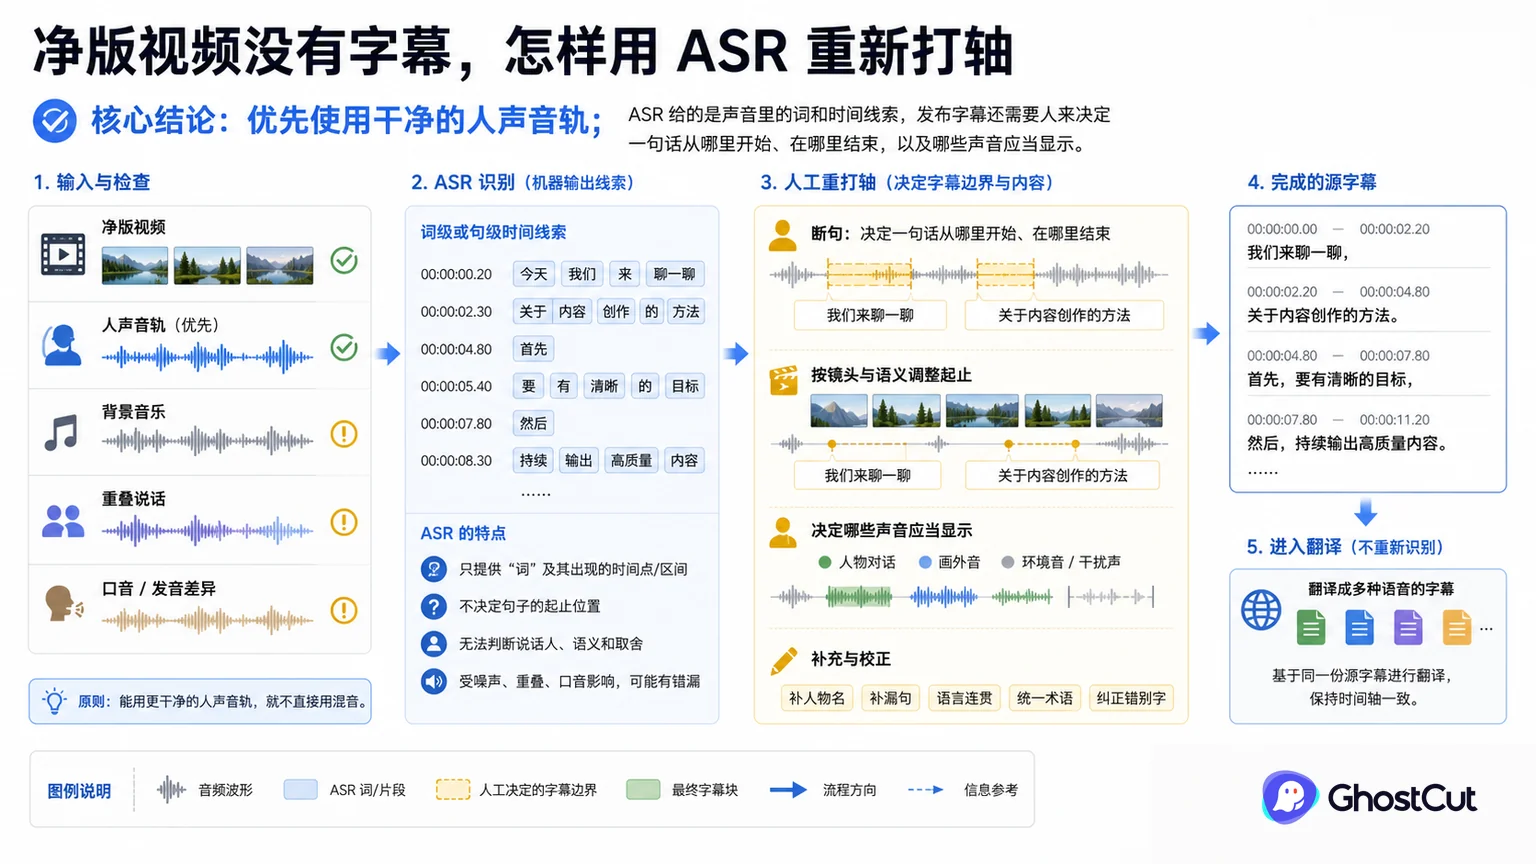
拿到无字母版时,画面问题解决了,字幕却可能完全缺失。制作团队若直接听写几十集,耗时高;若把 ASR 输出原样压回视频,又常出现一条字幕塞满整句、停留过短,或人物已经闭嘴字幕还没消失。 ASR 是把语音转成文字,并给出可用的时间线索。声音里的停顿不总是句子结束:角色可能犹豫后补上关键词,也可能被对方打断,自动结果因此容易形成过长或过碎的条目。整理时先确认对白完整,再结合镜头决定何时显示哪一段信息。这样建立的源字幕才能供翻译复用;如果每种语言各自重新识别,同一处漏句和时间偏差就会产生多套不同修法,后续难以一起校正。
净版视频看起来最适合直接开始翻译,但它往往没有任何时间文本。若每个目标语团队各自从声音重新识别,漏词、断句和时间轴会产生多套源稿,同一个人名也可能从第一步就出现不同写法。
先听音轨,再确认识别时间能否定位
开始前先听,不要只看波形。确认视频是否有独立人声、对白语言、背景音乐强度、回声、口音和多人重叠情况。
从语音初稿整理出可阅读的时间轴
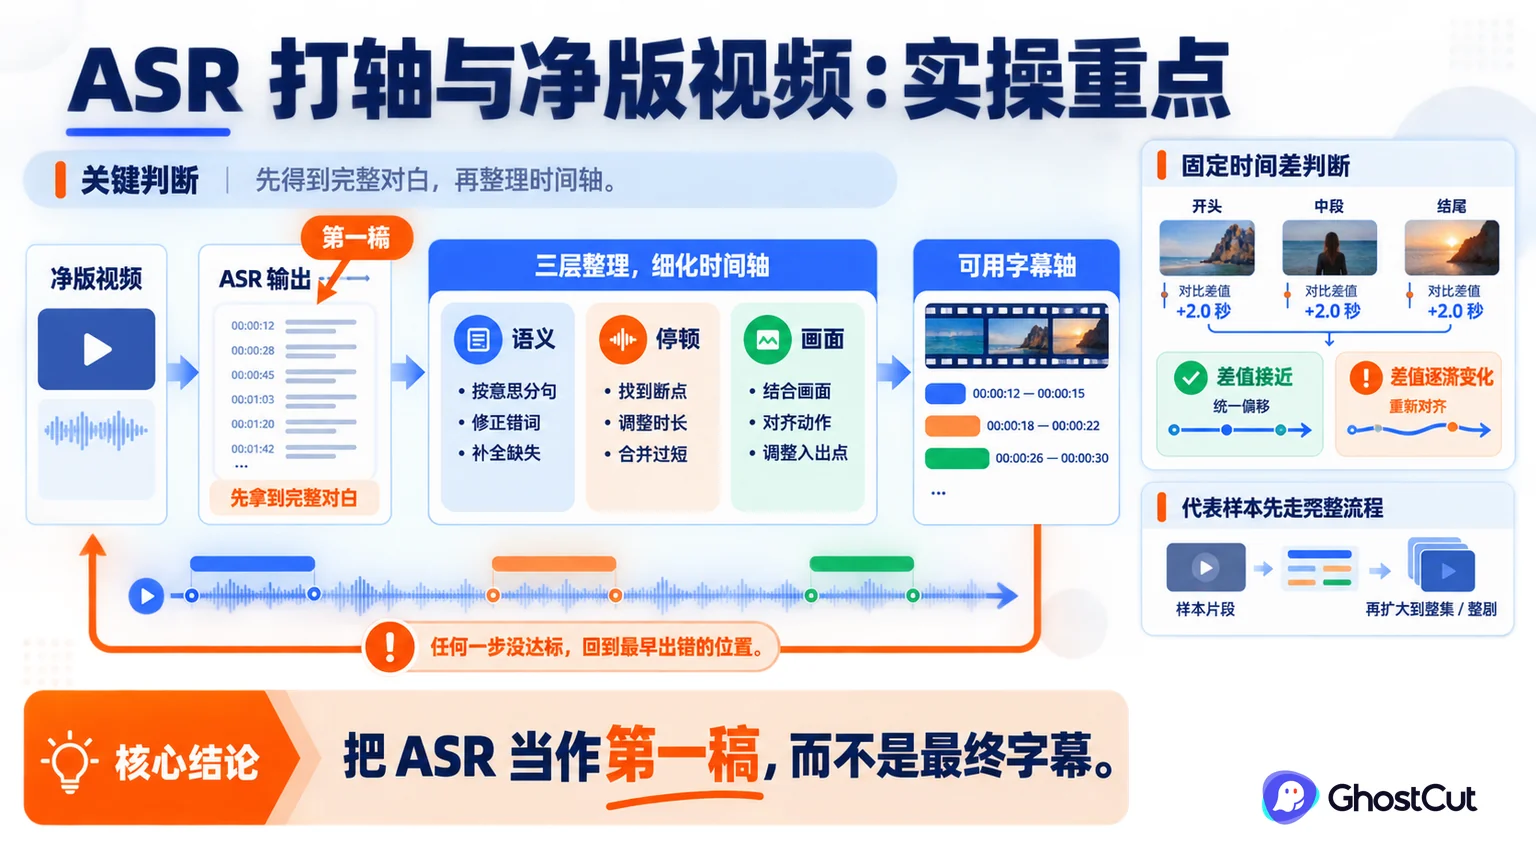
把 ASR 当作第一稿,而不是最终字幕。先得到完整对白,再从语义、声音和画面三个角度整理时间轴。
处理步骤
拿到词时间后,先按完整意思拼成短句,再回放前后对白调整边界。例如人物说完前半句停顿、镜头切到对方反应,后半句才揭示原因,就要判断字幕是否应分两次出现,避免提前把反转显示出来。抽出音频时保留原视频起点;若已裁去片头,记录裁切时长并补回时间。最后用开头、中段和结尾的清晰对白做锚点,分别比较偏差,确认是固定偏移还是中途剪辑导致的错位。 更稳的做法是先做一份经过校对的源语言字幕母版。争吵、电话声和音乐高潮处单独标记,普通对白按镜头连续播放;母版通过后,所有语言都从同一份时间轴派生,后续发现源文错误也只需追一条来源。
分清识别错字和字幕不同步
ASR 不准和字幕不好读是两类问题。前者先修声音与文本,后者先修断句和时间;混在一起会让团队反复换模型,却没有改善观看体验。
| 看到的问题 | 更可能的原因 | 先做什么 |
|---|---|---|
| 整集固定快两秒 | 音频与视频起点不同 | 用锚点测出偏移后整体移动 |
| 越到后面越不同步 | 帧率、采样或变速导致漂移 | 分段重新对齐并检查源文件 |
| 人名反复误听 | 缺少角色和专名词表 | 先确认写法,再批量回查 |
| 抢话合成一长句 | 自动分段依赖静音 | 按说话人与画面重新拆条 |
如果三个锚点相差同样的时长,整体平移后再检查局部句子;如果偏差突然从某个镜头开始,先找删减或拼接点,不要把整轨均匀拉伸。人名可在文本中回查,低声和抢话则定位到原音频补听。说话人 A、B 只是分离线索,还需根据前后镜头确认剧情人物,不能把当前出镜的人自动当成说话者。
源字幕交给翻译,人物备注交给配音
保存源语言字幕、词级或句级时间、说话人备注、听不清的片段和校对版本。配音团队还需要知道画外音、旁白和角色归属,不能只收到一份没有人物信息的 SRT。 对白极少、音乐很强或需要逐字法律准确时,人工转写可能更合适。若上游能补交台词表,也应与 ASR 对照使用,而不是忽略现成文本。
确认一次源字幕,供后续语言复用
GhostCut 可以从视频建立字幕初稿,并把校对后的源字幕继续用于整剧翻译、角色标记和配音。若项目必须完全离线,可使用本地 Whisper 等方案,但团队要自行承担模型部署、时间轴编辑和版本管理。 打轴完成后,字幕是否读得完仍需单独检查。源语言看似合适的长度,翻成西班牙语或德语后可能马上超出显示时间。