先听出是混音、专名还是多人抢话的问题
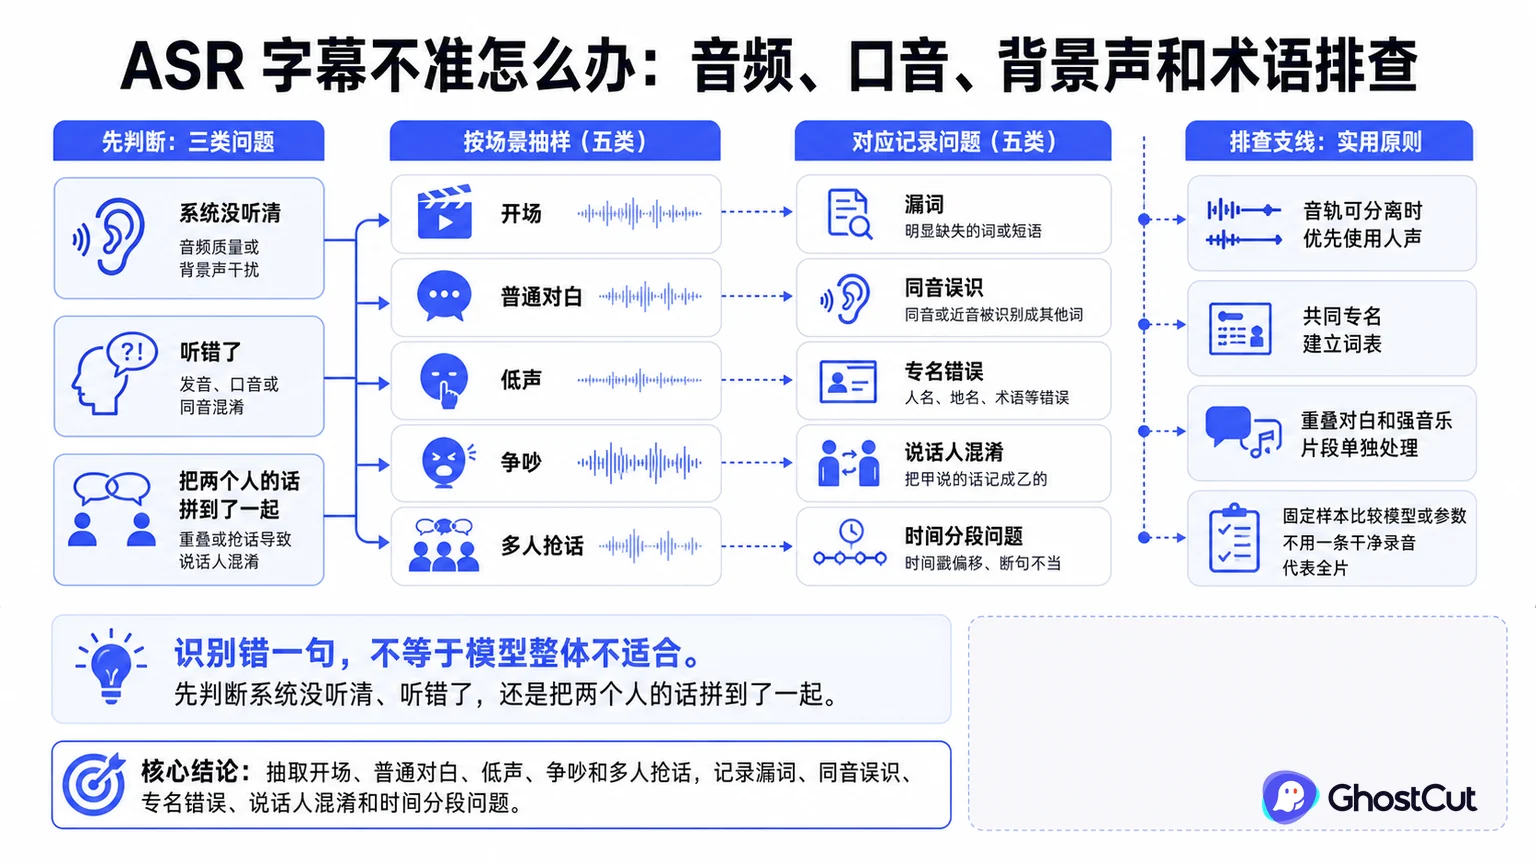
同一集里,安静室内对白可能识别得很顺,争吵、电话声和音乐高潮却漏掉整句。若只看整体文字准确率,团队看不到错误恰好集中在剧情转折和付费节点,发布后反而是最关键的内容先出问题。 背景音乐盖住人声,与角色名被识别成常用词,需要不同的处理。前者先查是否能取得更清楚的对白轨,后者可能只需用人物资料确认文本;两人同时说话时,还要检查是否有一人的整句被漏掉。先听声音再读转写,可以避免被通顺的文字误导。把错误对应到声音条件,后续测试降噪、换模型或补词表才有明确目标,而不是整集反复重跑却看不出哪一类问题减少了。
ASR 的整体准确率看起来不错,也可能在剧情最重要的地方出错。普通对白容易识别,身份揭晓时的低声耳语、争吵中的抢话和带音乐的告白反而最容易漏词,而这些句子恰好决定观众是否看懂反转。
按声音条件建立一组对照片段
选样本时按声音条件而不是随机集数。每类至少保留几段,后续换模型、降噪或改词表都用同一批回归。
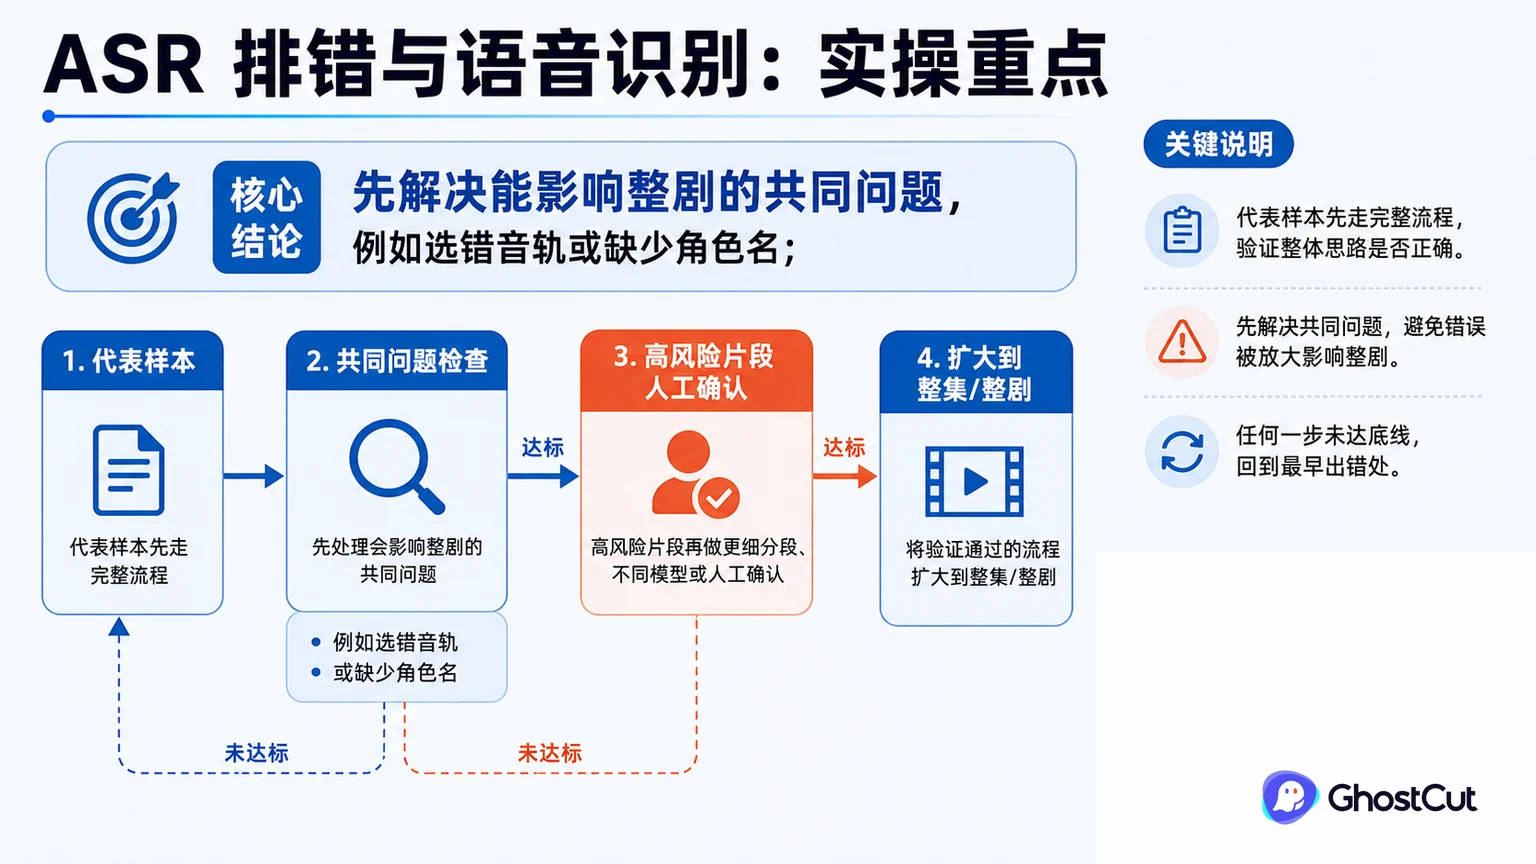
先修音轨和共同错误,再补听难句
先解决能影响整剧的共同问题,例如选错音轨或缺少角色名;再对高风险片段使用更细的分段、不同模型或人工转写。
处理步骤
用同一段原音和处理后音频分别识别,再对照漏词位置。如果背景音乐变轻了,轻声辅音却也消失,应撤回这次降噪,而不是继续加大强度。多人对白可先切出带前后句的片段,避免截掉起音或失去指代关系;已经有独立对白轨时优先使用分轨。降噪、分段和换模型分开测试,才能知道哪一步改善了输入,哪一步只是让错误变成了另一种通顺说法。 把错误和音频条件放在一起看:专名反复错就补词表,音乐压住人声就换用分离后的对白轨,抢话则拆开说话人和时间。这样修改有明确去处,不会把所有问题都归成一句“模型不准”。
通顺的转写也要检查人名、数字和漏句
ASR 输出看起来通顺也可能是错的。模型会把听不清的专名补成常见词,因此必须特别检查角色名、金额、日期和改变剧情关系的句子。
| 看到的问题 | 更可能的原因 | 先做什么 |
|---|---|---|
| 主角名变成常用词 | 缺少剧集专名 | 建立角色表并全文搜索变体 |
| 争吵时漏掉一人 | 重叠说话无法稳定分离 | 结合画面、分轨或人工转写 |
| 音乐高潮整段空白 | 人声被混音掩盖 | 尝试人声分轨或单独处理 |
| 句子文字对但时间乱 | 静音分段与短剧节奏不匹配 | 保留词时间并重新断句 |
角色名反复变成常用词时,先根据剧本、片头或已确认对白确定写法,再搜索各类误识,不要直接做无条件全文替换。若争吵中只识别出一人,回听两人的发言起止并分别补入;画面和声音都判断不了时,把时间码标为“待听辨”,交给熟悉原剧的人处理。补完后连同前后句一起播放,确认没有重复插入原本已经识别出的台词。
留下原声,让译者能回听不确定台词
保留原音轨、处理后音轨、原始 ASR、批准字幕、说话人备注和不确定片段。字幕翻译与配音都应从批准文本开始,同时能回到原声核对情绪和人物。 高保密、法律要求逐字准确或声音极差的素材,人工转写和双人复核可能更合适。开源本地模型可满足离线要求,但仍需算入算力、部署和编辑成本。
把确认后的字幕和角色带入译配
GhostCut 可以把视频转写、角色标记、上下文翻译和配音继续放在同一部剧下,减少每个语言重新解释人物的工作。它不替代对关键台词的听审,也不能从完全不可懂的声音中恢复确定文本。 文本确认后,下一步是把识别时间整理成观众能读的字幕。语音停顿和字幕断句并不总是一回事。