先分清对白字幕和其他画面文字
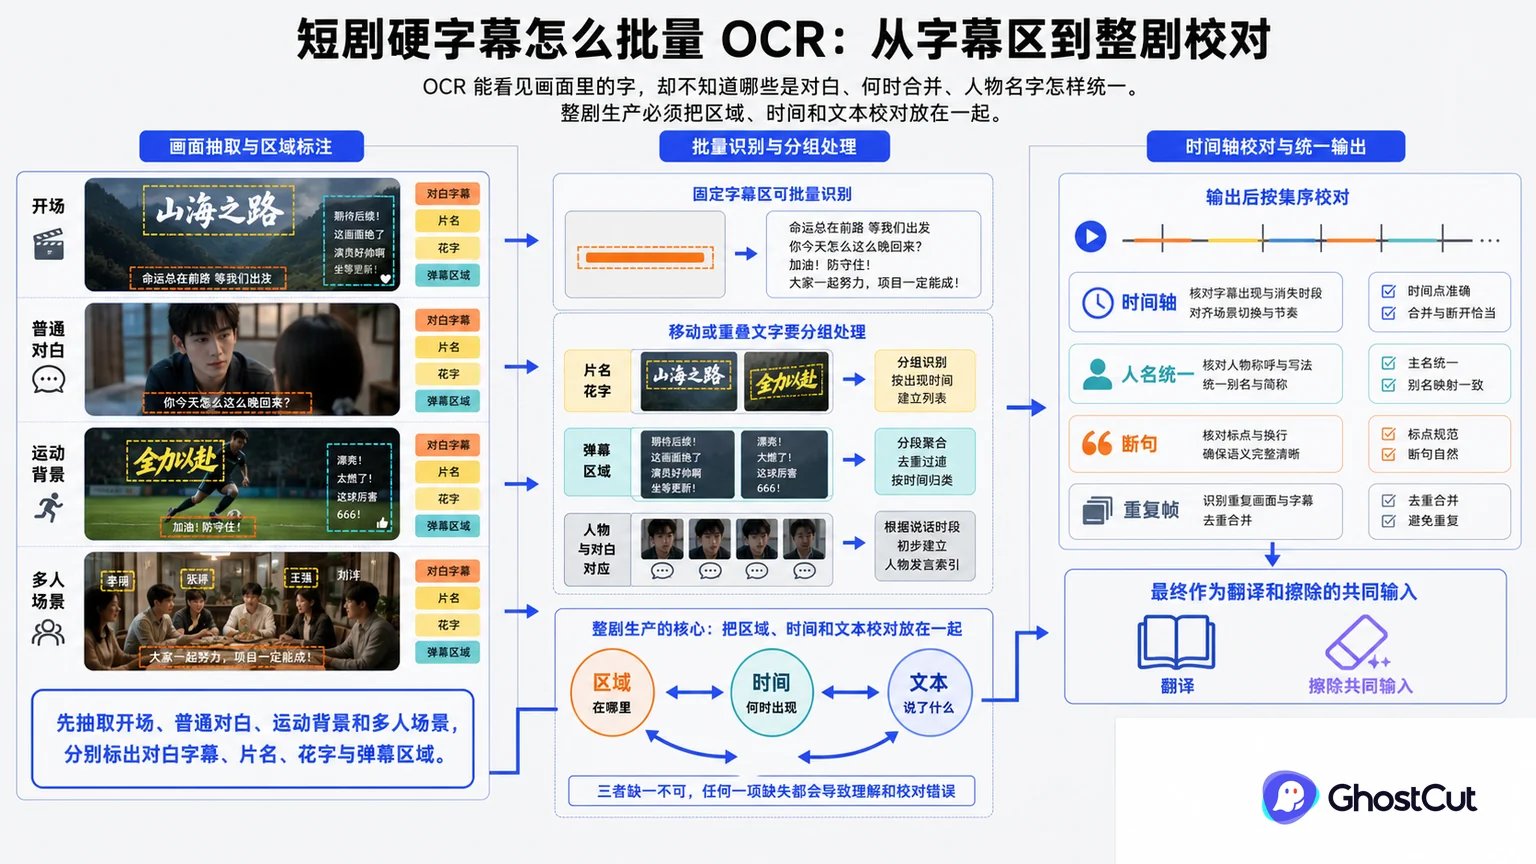
一部短剧的对白字幕通常在底部,但开场片名、人物卡、聊天气泡和平台包装也都是画面文字。直接对全屏逐帧识别,系统会把片名重复几十次,把飘过的弹幕插进对白,还可能为同一句字幕生成许多相邻时间片。 OCR 是从画面像素中识别文字,本身并不知道某行字是对白还是平台包装。只要两类字一起进入字幕,翻译就可能把水印也当成台词,配音还会念出人物名卡。先确定哪些画面文字需要进入目标字幕,再把同一句连续出现的帧整理成时间条目,人工才是在校对对白,而不是清理大量无关结果。跨集共用的区域规则也要看版式是否一致,不能因为第一集在底栏,就假定整剧位置不变。
一部短剧常有几十集,同一套对白字幕之外还夹着片名、人名条、聊天气泡和平台角标。若第一集把所有文字都放进同一个识别区域,后面得到的不会只是少量错字,而是一批重复、串行和无法直接翻译的文本。
用不同字体、位置和背景检查样片
不要只挑白底黑字的普通镜头。样本要覆盖压缩严重、人物经过字幕区、字幕换行、双色描边、快速切镜和片头片尾。
先识别区域,再把连续帧整理成字幕
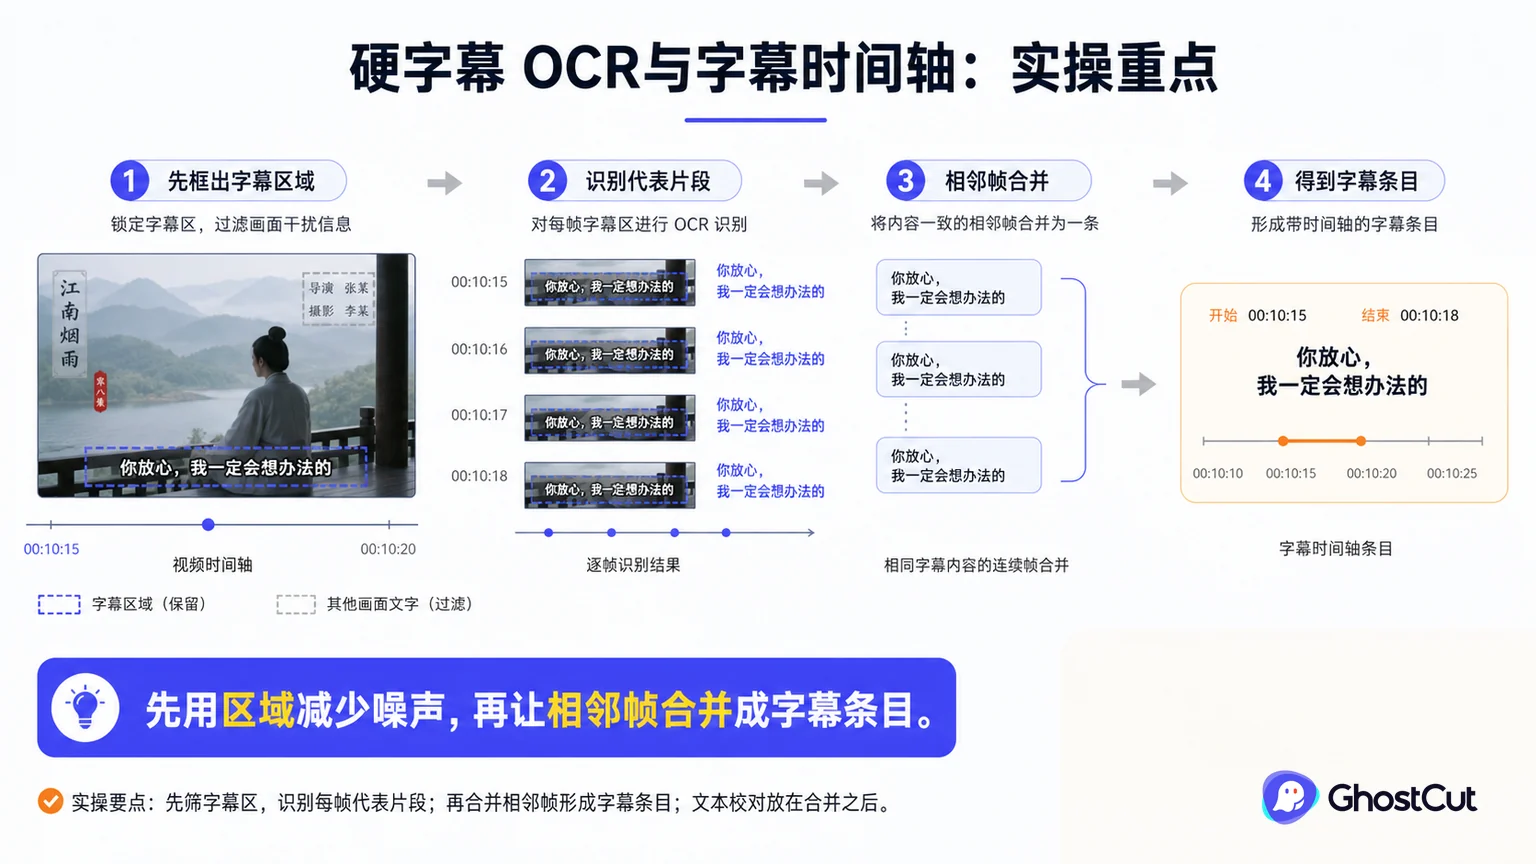
先用区域减少噪声,再让相邻帧合并成字幕条目。文本校对放在时间合并之后,否则操作人会在几十个重复帧上改同一句话。
处理步骤
合并时同时看文字和时间。例如一句字幕持续显示两秒,逐帧识别出的近似文本应归成一个条目;它消失后又被角色重复说出,则要保留为第二条,不能因为文字相同就合并。起止帧还要回看视频,以免采帧间隔漏掉短句。OCR 与 ASR 不一致时,再核对画面与声音:聊天消息可能只在画面里,画外音可能只有声音,两路结果不能简单取交集。 例如字幕在切镜头时停留了两帧,OCR 可能把同一句识别成三条。先把跨帧合并规则调稳,再校对文字,比让编辑逐集删除重复条目更省时间;这个规则也要和字幕区域、集序及源视频版本一起保存。
重复、漏字和人名错误要分开修
错字很多时,不要先认定模型不行。区域过大、源视频压缩、帧采样过密和字幕类型混杂都会制造看起来像识别能力的问题。
| 看到的问题 | 更可能的原因 | 先做什么 |
|---|---|---|
| 同一句重复几十条 | 逐帧结果没有按时间合并 | 先合并相邻帧,再校对文本 |
| 人名每集写法不同 | 没有角色和术语表 | 确认首次出场写法并全剧回查 |
| 漏掉白色描边字幕 | 背景和阈值让文字边缘消失 | 调整区域、缩放或预处理样本 |
| 把水印当对白 | 全屏识别未区分文字类型 | 单独屏蔽固定水印与包装区 |
从错误表看问题集中在哪一层。若字幕位置在片头后发生变化,调整对应时段区域并重跑;若时间正确、只是主角姓名多种写法,确认角色表后搜索相关文本即可。修复后回放这段以及相邻的正确段,检查新规则有没有合并两次独立发言。确认规则稳定,再用于相同版式的后续集数。
文字与区域时间信息分别留存
保留原始 OCR 结果、合并后的时间轴、人工批准字幕和异常镜头清单。翻译应使用批准字幕,擦除则继续使用位置与时间信息,两边都能追溯到同一段画面。 已经拿到与母版匹配的 SRT 或 ASS 时,先校对源字幕,通常不需要重新 OCR。低清、强运动和大面积遮挡若无法稳定识别,应回查源文件或结合 ASR 与人工转写。
让提取结果继续用于整剧翻译和净版
GhostCut 可以从多集硬字幕视频提取字幕,并让校对后的文本继续用于字幕擦除、上下文翻译和配音。它适合需要复用整剧结果的项目;单张截图识字或已有准确字幕文件时,使用更轻的工具会更直接。 字幕文字拿到后,还要继续问时间轴是否能直接使用。识别正确但断句和显示时长不合适,观众仍然会读得很累。