先看错字集中在哪种画面
看到 OCR 初稿满是错字,团队很容易直接换模型。可同一个模型在白底片尾认得很好,在人物衣服、灯光和运动背景上却持续出错;也可能文字本身识别正确,只是在连续帧里被重复合并成几条。 同样是“字幕不对”,没有检测到第二行、把一个字认成同音字、把一句拆成重复条目,发生的位置并不相同。区域和取帧决定输入有没有文字,识别负责读出字,时间合并再把帧变成字幕条目。先分清哪一层出错,才能只改相关条件。若直接更换模型,旧的合并问题仍在,新模型又可能换一种人名写法,团队更难判断这次调整究竟改善了什么。
OCR 错字多时,最容易发生的误判是不断换模型,却没有先看错误集中在哪里。白字黑边在普通室内镜头很稳定,但一到雪景、霓虹灯或人物白衣上就漏字,这通常是画面条件和区域设置的问题。
把正确和错误样本放在一起比较
抽样要包含正确结果和错误结果,才能看出差异。只收集最坏截图会让团队误以为整剧都不可用,也看不到哪些条件已经稳定。
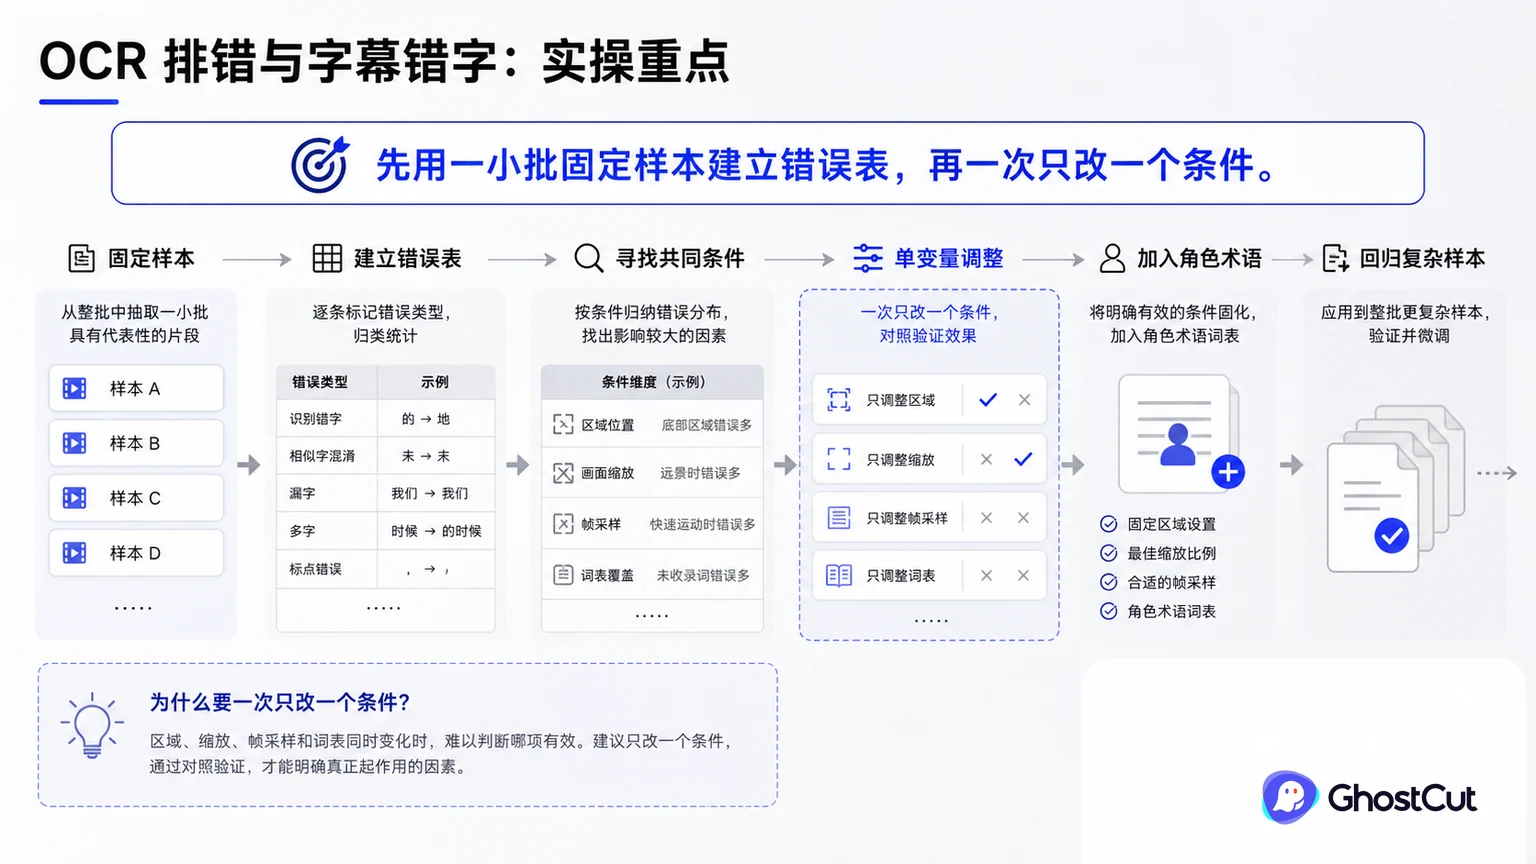
固定样本,每次只调整一个条件
先用一小批固定样本建立错误表,再一次只改一个条件。区域、缩放、帧采样和词表同时变化时,即使结果变好也不知道是哪项有效。
处理步骤
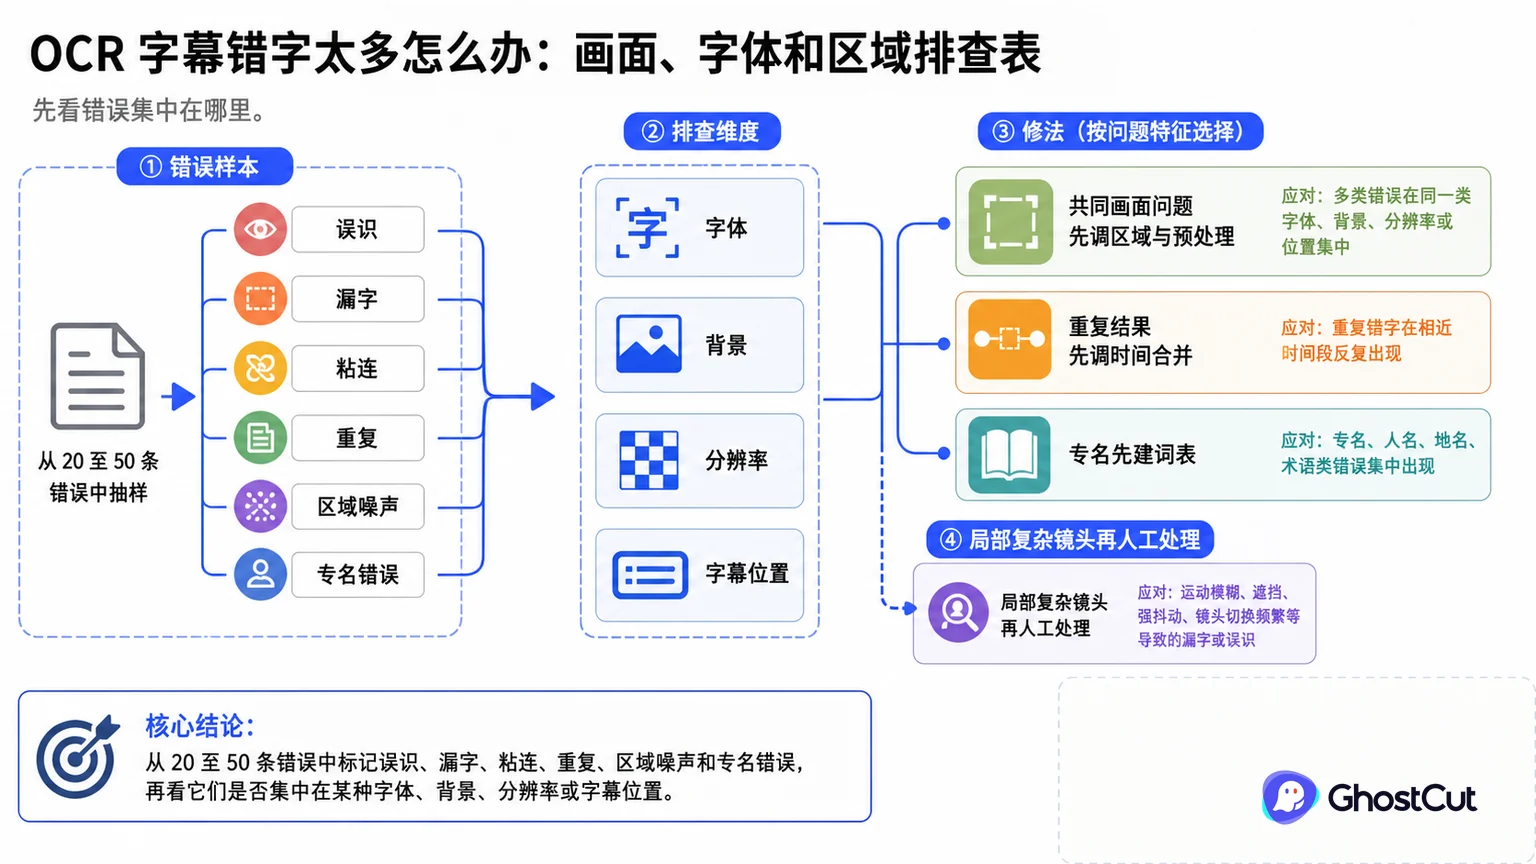
把原截图、识别文本和预期文本并排看,先判断“没框到字”还是“框到了但认错”。前者查区域与取帧,后者再测试缩放、描边处理和识别设置。比如对白区高度变化后第二行持续漏掉,应先扩大到实际文字边缘,而不是增加人名词表。词表可用于识别服务支持的提示或后续文本校对,但不能补回未检测到的句子。每次调整也要重看正确样本,防止新规则把背景文字带进字幕。 先把错误按字体、背景、位置和时间合并方式分组,团队才知道要改图像预处理、字幕框还是词表。若几十条错误都来自同一种描边,修一次共同设置比在译文阶段反复纠正同音人名更有效。
按误字、漏句和重复选择修法
先处理会反复传播的错误,再处理零散难字。主角名字在多集都错,应搜索同一读音的写法;只在一个快速转身镜头漏字,则检查该句显示期间有没有更清晰的帧。下面的排查表用来选择下一次操作,修复效果要回到原字幕区确认,不能仅以输出句子变通顺作为依据。
| 看到的问题 | 更可能的原因 | 先做什么 |
|---|---|---|
| 所有角色名都写错 | 通用模型缺少剧集专名 | 建立角色术语表并全剧回查 |
| 双色描边字粘成一团 | 文字边缘和背景分离失败 | 裁区域、放大并测试预处理 |
| 运动镜头经常漏句 | 采样时刻字幕模糊或被遮挡 | 在持续区间选更清晰帧 |
| 同一句出现多次 | 文本正确但时间合并失败 | 调整相似度与持续时间规则 |
共同错误修复后,要重新检查已经人工改过的字幕,避免新规则覆盖批准文本。最好把原始识别、自动修订和人工批准分成三个版本,而不是在一份文件上来回覆盖。
保留错误样本,也保留人工校正稿
错误表应保留截图、时间码、错误类型、原因判断、处理动作和修复结果。它既是本剧的回归样本,也能帮助下一部相似字体或平台包装的剧更快确定参数。 源视频字幕像素过低、被强遮挡或本身就是生成式假字时,OCR 可能没有足够信息恢复。此时要结合音频、台词表和人工判断,不应承诺从不可辨认像素中还原唯一答案。
同类字幕稳定后,再扩到后续集数
GhostCut 适合把硬字幕提取、角色术语校对和后续擦除放在同一剧集里继续处理。对于少量图片识字,通用 OCR 更轻;对于复杂镜头,仍要保留人工回退和源素材补要。 文字修准以后,要继续检查同一句何时出现和消失。时间轴偏差不会显示成错字,却会直接影响翻译、配音和观看。