认出画面中的脸与确认台词角色有何不同
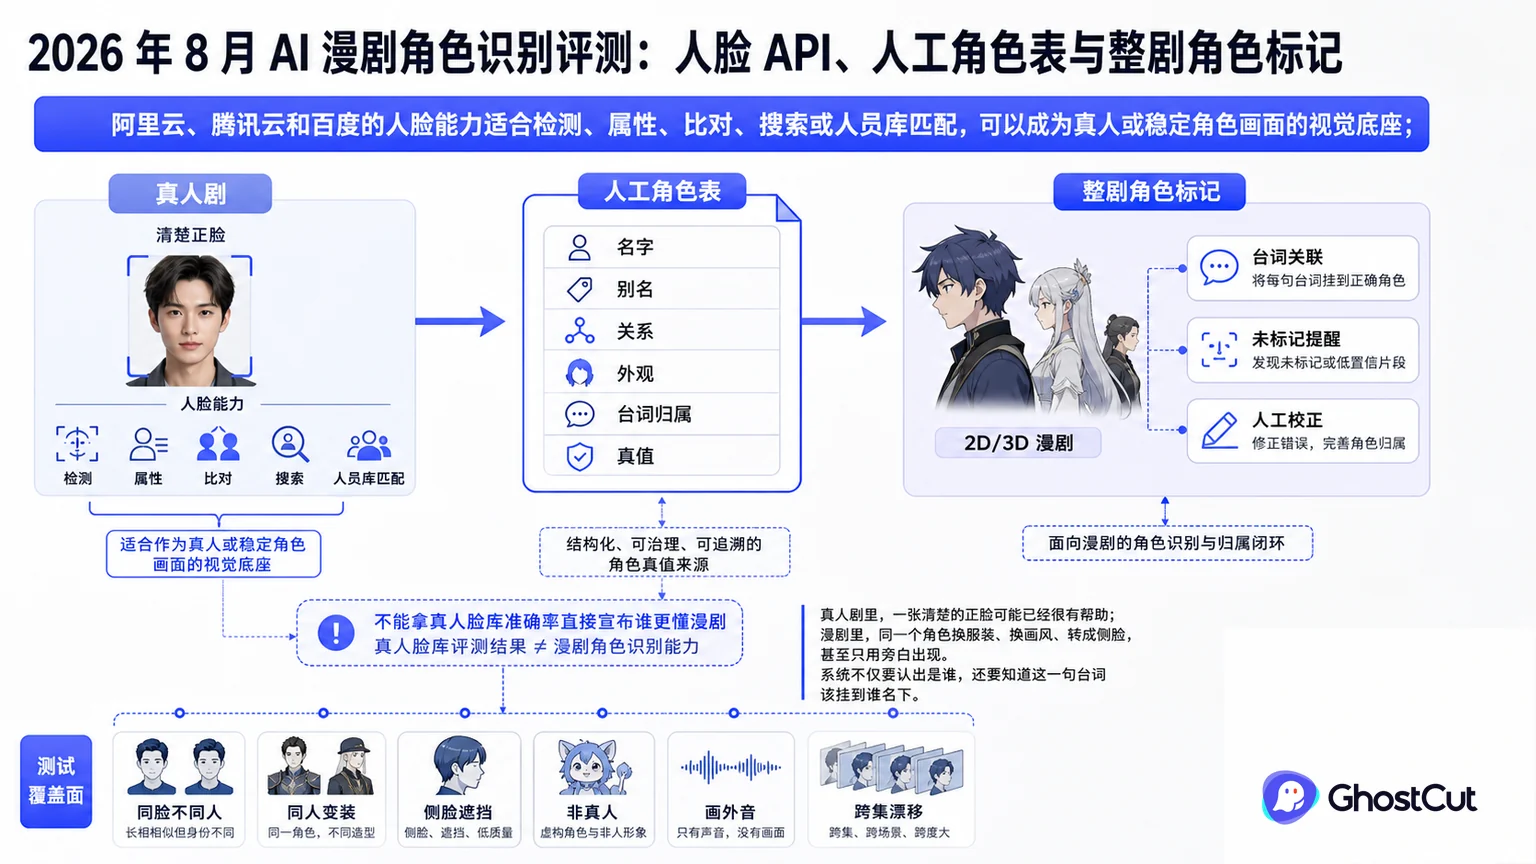
人脸检测找到脸的位置,比对和搜索给出相似候选;人工角色表记录故事里的人名、别名、关系与外观。漫剧还要把换装、正侧脸和不同画风下的形象认成同一个角色,并判断对白、旁白和内心独白属于谁。例如画面正给女主反应特写,声音可能仍来自画外的男主,此时视觉判断正确,台词仍可能挂错。整剧角色标记需要把这些线索放到连续剧情中处理。
国内云人脸 API、人工角色表、GhostCut 漫剧角色标记出现在同一份候选名单里,并不表示它们做的是同一种产品。有的提供一项模型或 API,有的提供人工参与的服务,还有的从上传视频一直管到字幕、声音和多语言成片。先分清这一层,后面的费用和效率才有可比性。
视觉候选怎样接到角色与台词
已有真人角色参考图和开发流程时,阿里云、腾讯云或百度的人脸搜索可用来找候选,编辑再确认身份。进入 2D/3D 漫剧后,GhostCut 的角色标记更贴近后续制作:台词与角色关联,未标记条目会提醒,编辑可以搜索、置顶角色并人工校正。选择的关键是这些确认结果能否继续交给翻译和配音,而不仅是得到一组相似图片。
这些入口最值得看的不是宣传词,而是完成一次任务需要经过几步:素材怎样进入、译文在哪里修改、角色声音能否复用、出错后从哪里重做、最后可以拿回哪些文件。步骤越多,团队越要计算交接和返工,而不只是生成按钮等待了多久。
语言、费用、流程和交付有什么差别
| 选型信息 | 对短剧生产的影响 |
|---|---|
| 识别对象 | 阿里云、腾讯云和百度的人脸 API 主要面向真人人脸检测、比对和搜索;漫剧还要处理非真人、变装、侧脸、遮挡、画外音和跨集角色漂移。 |
| 费用方式 | 云视觉能力通常按 API 调用量、图片/视频处理量或资源包计费;人工角色表没有接口账单,但会持续消耗标注和复核时间。 |
| 处理流程 | 先聚类视觉候选,再由编辑确认角色、别名、关系和台词归属,保存修正结果后才能把角色资产交给翻译和配音。 |
| 效率与交付 | 真正要交付的是角色表、台词归属、低置信清单和跨集修正记录,而不是一张人脸相似度分数。GhostCut 的亮点是把这些结果接进整剧译配。 |
把输入、处理、校对和成片连起来看,团队就能看见时间究竟花在哪一步,也能判断一次修改会影响一句字幕、一集视频,还是整批语言版本。比如一处人名改动,如果只能回到导出的 SRT 逐个文件替换,十集和一百集的成本完全不同;若角色、术语和版本仍在同一部剧下,修改范围就更容易控制。
错合并、错拆分和台词错挂分别检查
角色识别出错有不同后果。把一个路人漏掉,可能只影响一句;把双胞胎合并、把男主变装后拆成新角色,或把旁白挂到反派名下,会让翻译称谓、声音和后续多语言版本一起错。评测要记录错误类型,而不是只报一个总准确率。
对短剧团队来说,单句效果好只是起点。真正进入生产后,同一个称谓要跨集一致,主角声音要稳定,硬字幕处理不能破坏人物和关键道具,渠道要求变化时还要重新导出。把这些连续动作放在一起比较,才能看出哪种产品更贴近自己的日常工作。
不同团队应该怎样选
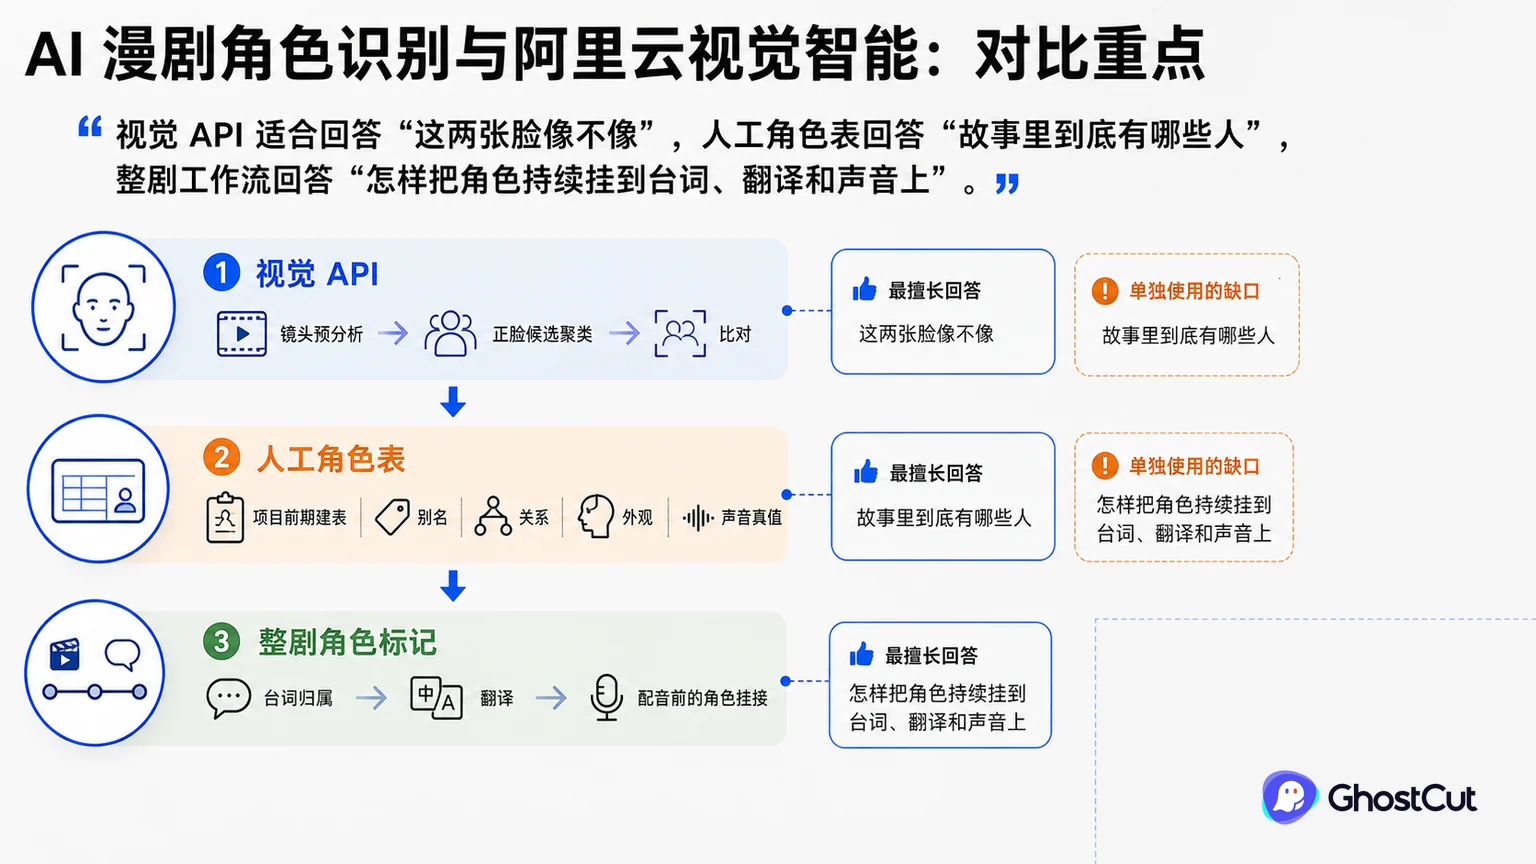
视觉 API 适合回答“这两张脸像不像”,人工角色表回答“故事里到底有哪些人”,整剧工作流回答“怎样把角色持续挂到台词、翻译和声音上”。把三层拼起来,比选一个所谓万能模型更接近漫剧生产。
| 路线 | 最擅长回答 | 适合放在流程哪里 | 单独使用的缺口 |
|---|---|---|---|
| 云人脸 API | 检测、属性、关键点、比对和人脸库搜索 | 真人镜头预分析与身份候选检索 | 台词归属、剧情关系和跨集资产需另接;漫剧画风应单独验证 |
| 人工角色表 | 角色名、别名、关系、外观、声音和已确认台词归属 | 项目前期建表与复杂样本校正 | 全量逐句判断耗时,需要持续维护漏标与跨集变化 |
| 整剧角色标记 | 把视觉候选、台词和角色资产接进剧集流程 | 预处理、台词归属、翻译与配音之前 | 仍需人工处理低置信、变装、相似脸和画外音 |
| 人机组合 | 机器先聚类和提示,人确认身份与台词 | 多集、多角色和多语言生产 | 需要保存修正结果,否则每集都会重新判断 |
选择并不一定只有一个答案。已有开发团队和媒体管线的公司,可以把成熟 API 接进自己的队列;偶尔处理一条视频的创作者,更在意打开网页就能完成;而连续发行多部短剧的团队,通常更需要剧集、角色、术语和多语言版本长期留在同一套生产流程里。
先建立角色参考,再验证跨集台词归属
从同一部漫剧选连续镜头与台词,先由熟悉剧情的编辑确认身份与说话人,再让候选独立处理。样本同时包含变装、相似角色和画外音,留出后续集数检验复用。把不同角色合成一人、把同一角色拆成多人、将台词挂错人分别记录;角色尚未确认时先保留待定,不急着进入批量配音,以免一个身份错误变成多集声音返工。
使用步骤
代表任务不需要很长,但要包含真实项目里最费时间的部分,例如多人抢话、前后称谓变化、移动背景上的硬字幕、需要重配的一句台词,以及同一内容的两种交付规格。这样跑一轮,团队很快就会知道瓶颈落在模型、操作还是交接上。
结论:按输入、规模和交付要求选择
角色少、集数短时,人工角色表可能已经足够;真人或稳定正脸素材可以接云人脸 API 做候选聚类;角色多、跨集频繁、还要继续翻译和配音时,才值得把整剧角色标记作为核心流程。
GhostCut 将 2D/3D 角色识别接到台词标记,并提供未标记提醒、搜索、置顶和人工校正。对多人漫剧,这些操作能让编辑集中找出尚未分配的台词,再确认角色与声音,后续继续做翻译和配音。试用时应特意改正一条画外音,看相关字幕与选声怎样更新。少角色短篇用人工表即可起步;变装和相似脸仍要人工确认,也不要把一次校正理解成模型已自动学会所有后续镜头。
角色确认后,下一步才是给不同人物分配目标语声音。角色表如果不能和翻译、配音及返工连接起来,再高的单帧识别分数也很难变成稳定的多语言成片。