三种审校方案,分别把人力放在哪里
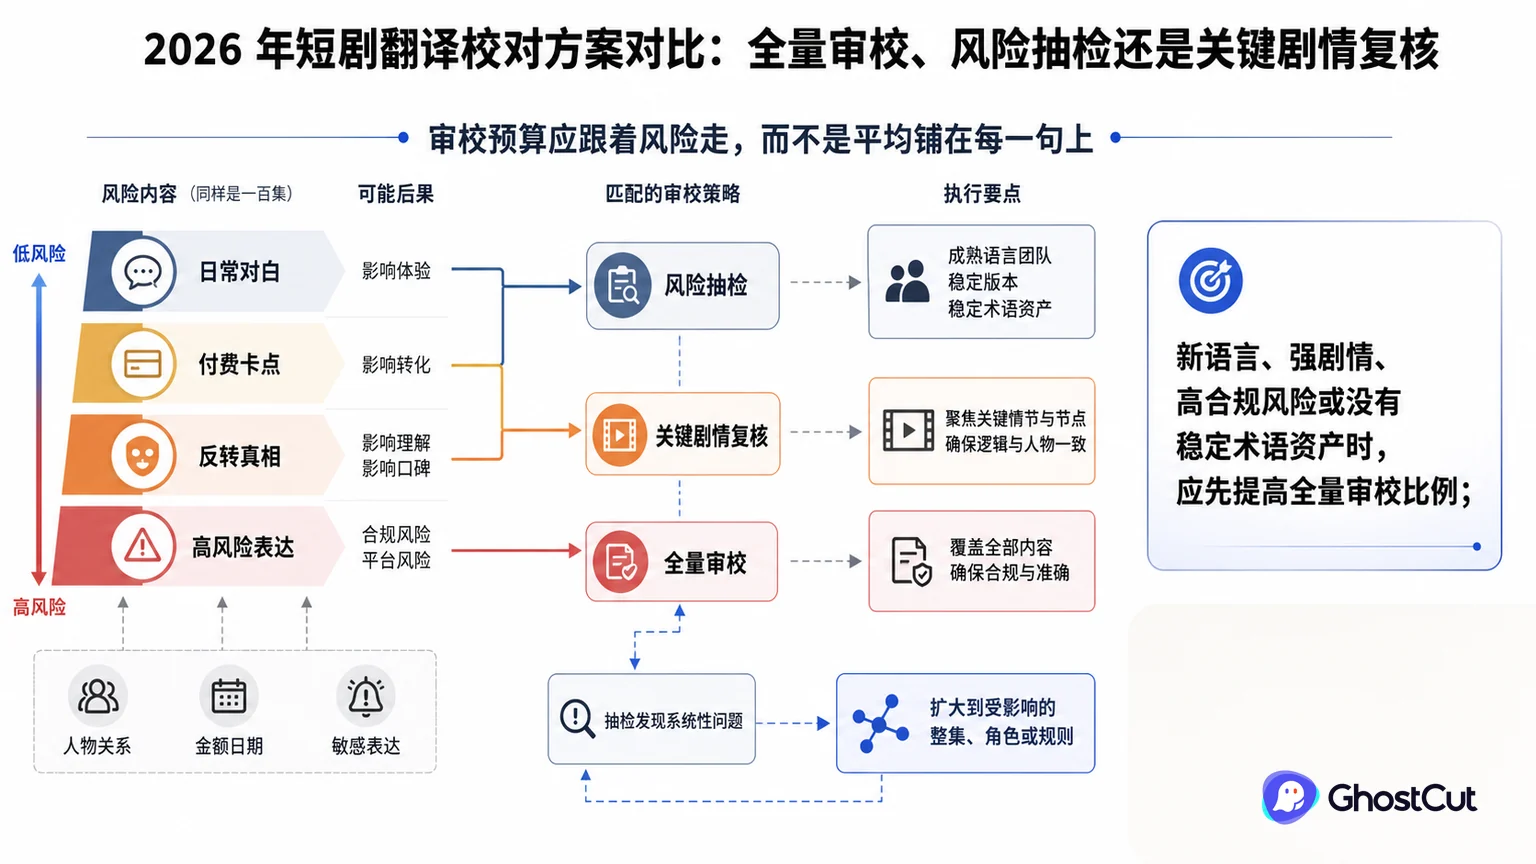
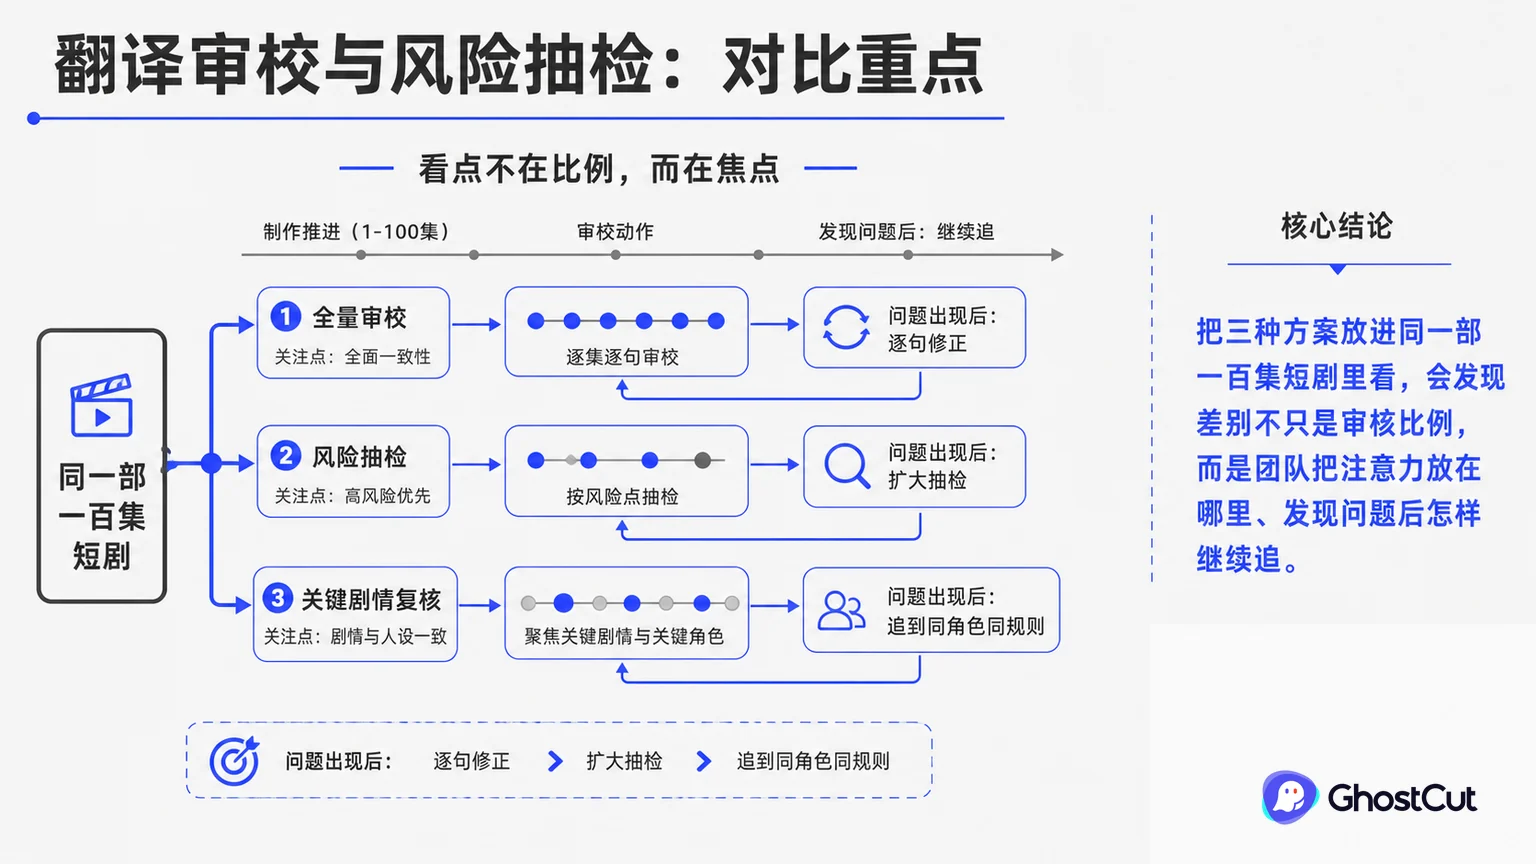
全量审校是目标语人员逐条查看所有字幕或台词;风险抽检是先按语言、题材、角色、画面和渠道把问题分层,再抽取代表片段;关键剧情复核则不追求平均覆盖,而是固定检查会改变理解、付费和合规结果的段落。三者不是互斥套餐,成熟项目通常会把它们叠在一起。
全量审校、风险抽检、关键剧情复核出现在同一份候选名单里,并不表示它们做的是同一种产品。有的提供一项模型或 API,有的提供人工参与的服务,还有的从上传视频一直管到字幕、声音和多语言成片。先分清这一层,后面的费用和效率才有可比性。
先找出会影响人物关系和剧情理解的错误
拿到初译后,可以先从人物关系找问题。例如,台词里的“哥”是在叫亲哥哥,还是对熟人的称呼?如果译文把这层关系说死,后面的恋爱或身世反转就可能被观众误解。这类错误应追查同一称谓在全剧中的用法;某一句不够口语化,则通常可以先在当前场景修正。有历史审校记录时,用它寻找反复出错的角色和表达;没有记录的新项目,先提高覆盖,积累判断依据。
这些入口最值得看的不是宣传词,而是完成一次任务需要经过几步:素材怎样进入、译文在哪里修改、角色声音能否复用、出错后从哪里重做、最后可以拿回哪些文件。步骤越多,团队越要计算交接和返工,而不只是生成按钮等待了多久。
语言、费用、流程和交付有什么差别
| 选型信息 | 对短剧生产的影响 |
|---|---|
| 适用范围 | 全量审校、风险抽检和关键剧情复核不是三种语言能力,而是三种质量责任分配方式。新语言、强剧情和高后果节点需要更高覆盖。 |
| 工作量 | 全量审校按字幕条目和台词逐条处理;抽检先按语言、角色、剧情和画面风险选样,再根据错误扩大到整集或同类规则。 |
| 生产流程 | 先建立角色表、术语表和错误目录,再做机器初稿、样本复核、问题归类和扩大复核,最后才确定常态抽检比例。 |
| 交付结果 | 校对好的字幕与成片一同保存,人名、称谓或剧情台词有调整时,也同步更新术语和角色记录,后续集数便能沿用。 |
把输入、处理、校对和成片连起来看,团队就能看见时间究竟花在哪一步,也能判断一次修改会影响一句字幕、一集视频,还是整批语言版本。比如一处人名改动,如果只能回到导出的 SRT 逐个文件替换,十集和一百集的成本完全不同;若角色、术语和版本仍在同一部剧下,修改范围就更容易控制。
哪些错误值得逐条检查
先不要问每集抽多少条。先问这批内容出错以后,观众是否还能继续理解,团队是否能局部修正,以及错误会不会已经进入多个语言和多个渠道。
对短剧团队来说,单句效果好只是起点。真正进入生产后,同一个称谓要跨集一致,主角声音要稳定,硬字幕处理不能破坏人物和关键道具,渠道要求变化时还要重新导出。把这些连续动作放在一起比较,才能看出哪种产品更贴近自己的日常工作。
全量、抽检和关键节点怎样搭配
假设要交付一部一百集短剧:全量审校能逐条照顾日常对白,却需要足够的目标语人员;风险抽检把时间集中到容易出错的片段,但前提是知道哪些内容可以归为同类;关键剧情复核直接守住身份揭示和反转,却覆盖不到所有阅读问题。因此,预算有限时可以组合三者,不能把“关键剧情看过了”当成全剧语言已验收。
| 方案 | 最适合的情况 | 主要代价 | 不能省掉的动作 |
|---|---|---|---|
| 全量审校 | 首个目标语言、强剧情或高风险题材 | 周期长,母语人力投入高 | 同时建立角色、术语和问题分类,逐句修改才不会反复 |
| 风险抽检 | 规则稳定、历史质量可追踪的连续生产 | 需要设计样本并维护错误记录 | 发现系统性问题后扩大到同角色、同集或同规则 |
| 关键剧情复核 | 预算有限但故事节点明确 | 可能漏掉普通段落里的语言问题 | 和基础抽检配合,覆盖普通段落的稳定性 |
| 组合方案 | 多集、多语言的常态项目 | 前期要把风险分层和责任写清 | 高风险逐条、普通段落抽检、发现问题后扩大 |
选择并不一定只有一个答案。已有开发团队和媒体管线的公司,可以把成熟 API 接进自己的队列;偶尔处理一条视频的创作者,更在意打开网页就能完成;而连续发行多部短剧的团队,通常更需要剧集、角色、术语和多语言版本长期留在同一套生产流程里。
用同一批初译片段比较漏检与返工
拿一部已经做完初译的剧,不要先随机抽十集。先把最容易暴露不同问题的片段放进同一批:开场人物关系、普通对白、争吵抢话、付费前悬念、身份反转和包含金额日期的段落。
使用步骤
代表任务不需要很长,但要包含真实项目里最费时间的部分,例如多人抢话、前后称谓变化、移动背景上的硬字幕、需要重配的一句台词,以及同一内容的两种交付规格。这样跑一轮,团队很快就会知道瓶颈落在模型、操作还是交接上。
先建立审校规则,再调整覆盖范围
是否降低覆盖,要看新一批内容还会不会出现同类错误。若反复发现人名、亲属关系或否定含义被译错,先暂停相关版本的配音和烧录,修正规则后扩大审校;若关键节点已确认、普通对白的错误也能稳定局部修正,再把部分日常段落转入抽检。全量审校同样需要复核分歧和修改结果,覆盖全部并不自动等于判断全部正确。
审校意见要能回到具体台词,才能在配音前改对版本。GhostCut 按剧组织角色、字幕、翻译和声音,适合把“这个称谓需要改”落实到对应集数,再处理受影响的配音与成片。试用时可选一处跨集称谓,检查修改后的字幕与声音是否一致、已确认版本是否保留。只有一份 SRT、无需配音的项目,用字幕编辑器配合审校表就能开始;人物关系和目标语表达仍由审校人员确认。
审校策略确定后,下一步要把它写成可执行的验收单:谁看文字、谁回到视频里检查、什么问题必须阻断发布,以及修订后由谁确认关闭。