声音对齐与嘴部重建各改动什么
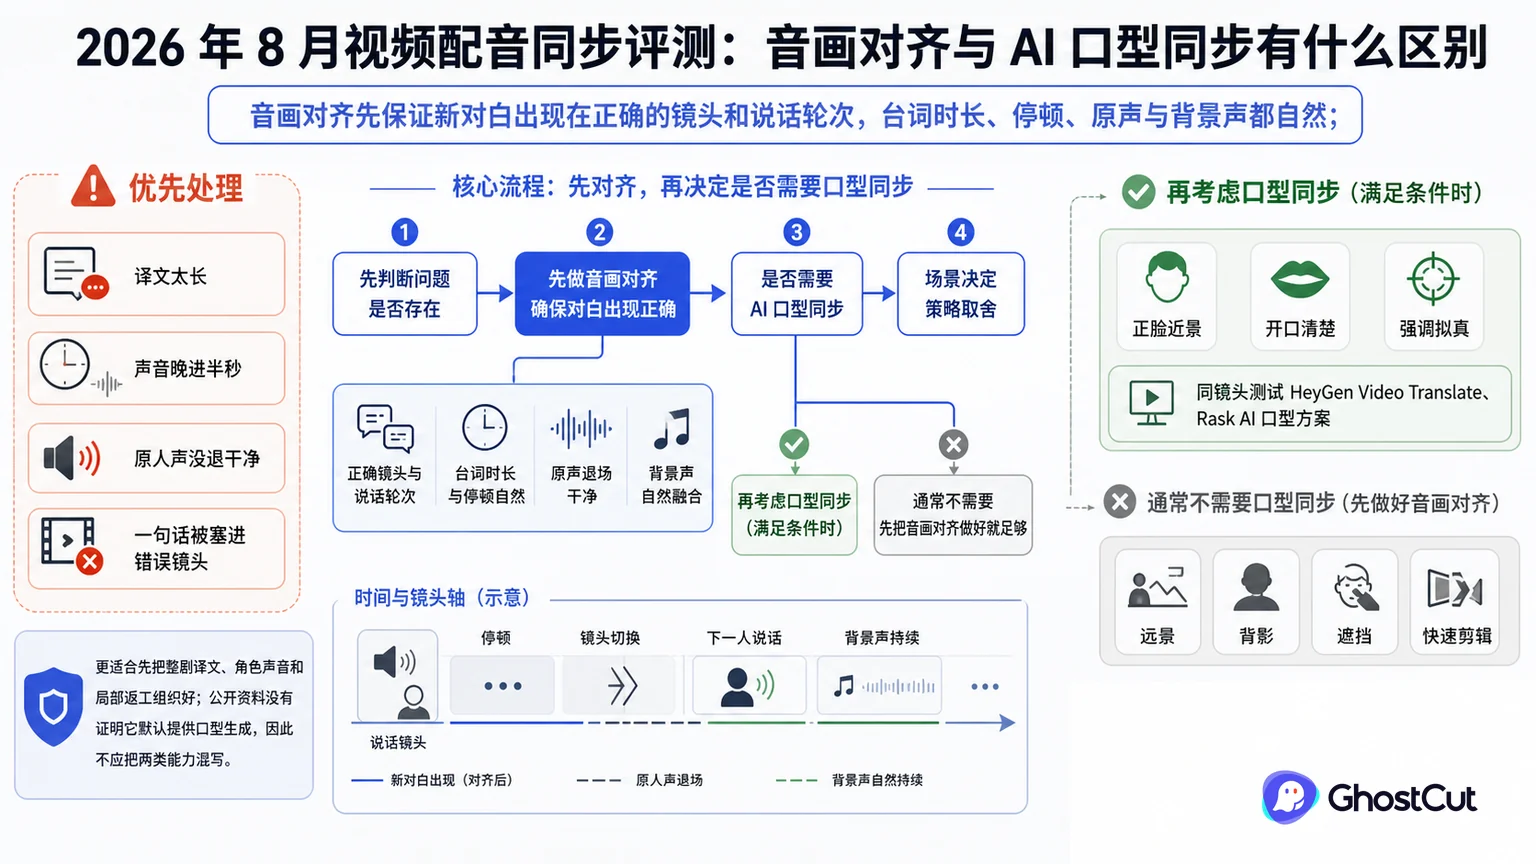
音画对齐处理听觉时序:谁在说、声音何时开始和结束、停顿是否落在动作之间、旧对白与背景声是否衔接。口型同步处理视觉生成:根据新音频改变嘴唇和部分面部运动。HeyGen 和 Rask 把视频翻译、声音与 lip-sync 放在产品中;GhostCut 强调多集译配生产。三条路线分别适合镜头处理、在线翻译和整剧版本管理,项目应按镜头风险选择组合。
HeyGen Video Translate、Rask AI Video Translator、GhostCut出现在同一份候选名单里,并不表示它们做的是同一种产品。有的提供一项模型或 API,有的提供人工参与的服务,还有的从上传视频一直管到字幕、声音和多语言成片。先分清这一层,后面的费用和效率才有可比性。
各家产品的功能与使用入口
HeyGen 将视频或 YouTube 链接、目标语言、声音克隆和口型同步放在同一入口,适合从单条视频开始试做翻译版。Rask 提供逐段编辑、配音、字幕下载与可选口型处理,便于把文本修订接到声音和画面。整剧制作还多一层角色和版本工作:GhostCut 连接角色、翻译、配音和合成,可以先完成这一层,再为需要口型的镜头安排后期处理。
这些入口最值得看的不是宣传词,而是完成一次任务需要经过几步:素材怎样进入、译文在哪里修改、角色声音能否复用、出错后从哪里重做、最后可以拿回哪些文件。步骤越多,团队越要计算交接和返工,而不只是生成按钮等待了多久。
语言、费用、流程和交付有什么差别
| 选型信息 | 对短剧生产的影响 |
|---|---|
| 处理范围 | 音画对齐只调整声音进入镜头的时间、时长和混音;HeyGen、Rask 等口型方案还会改动嘴部画面,适用镜头和失败风险不同。 |
| 费用方式 | 视频翻译和口型同步通常按视频分钟、套餐额度或项目计费。只给重要近景制作口型,可以把额外的画面生成和检查工作集中在观众最容易注意到的镜头上。 |
| 处理流程 | 先完成译文、角色声音和时长校对,再决定哪些正脸近景值得做口型;远景、背影和快速切镜通常先用音画对齐即可。 |
| 交付结果 | 除最终视频外,保留译文、字幕、配音音轨和口型处理镜头清单,方便一句修改时只重做受影响片段。 |
把输入、处理、校对和成片连起来看,团队就能看见时间究竟花在哪一步,也能判断一次修改会影响一句字幕、一集视频,还是整批语言版本。比如一处人名改动,如果只能回到导出的 SRT 逐个文件替换,十集和一百集的成本完全不同;若角色、术语和版本仍在同一部剧下,修改范围就更容易控制。
哪些镜头值得增加口型处理
同步质量要在连续播放中判断。嘴部像不像只是一个维度,声音与镜头的因果关系、演员动作、环境声和剪辑节奏共同决定观众是否觉得自然。
对短剧团队来说,单句效果好只是起点。真正进入生产后,同一个称谓要跨集一致,主角声音要稳定,硬字幕处理不能破坏人物和关键道具,渠道要求变化时还要重新导出。把这些连续动作放在一起比较,才能看出哪种产品更贴近自己的日常工作。
按嘴部可见度与修改频率选择路线
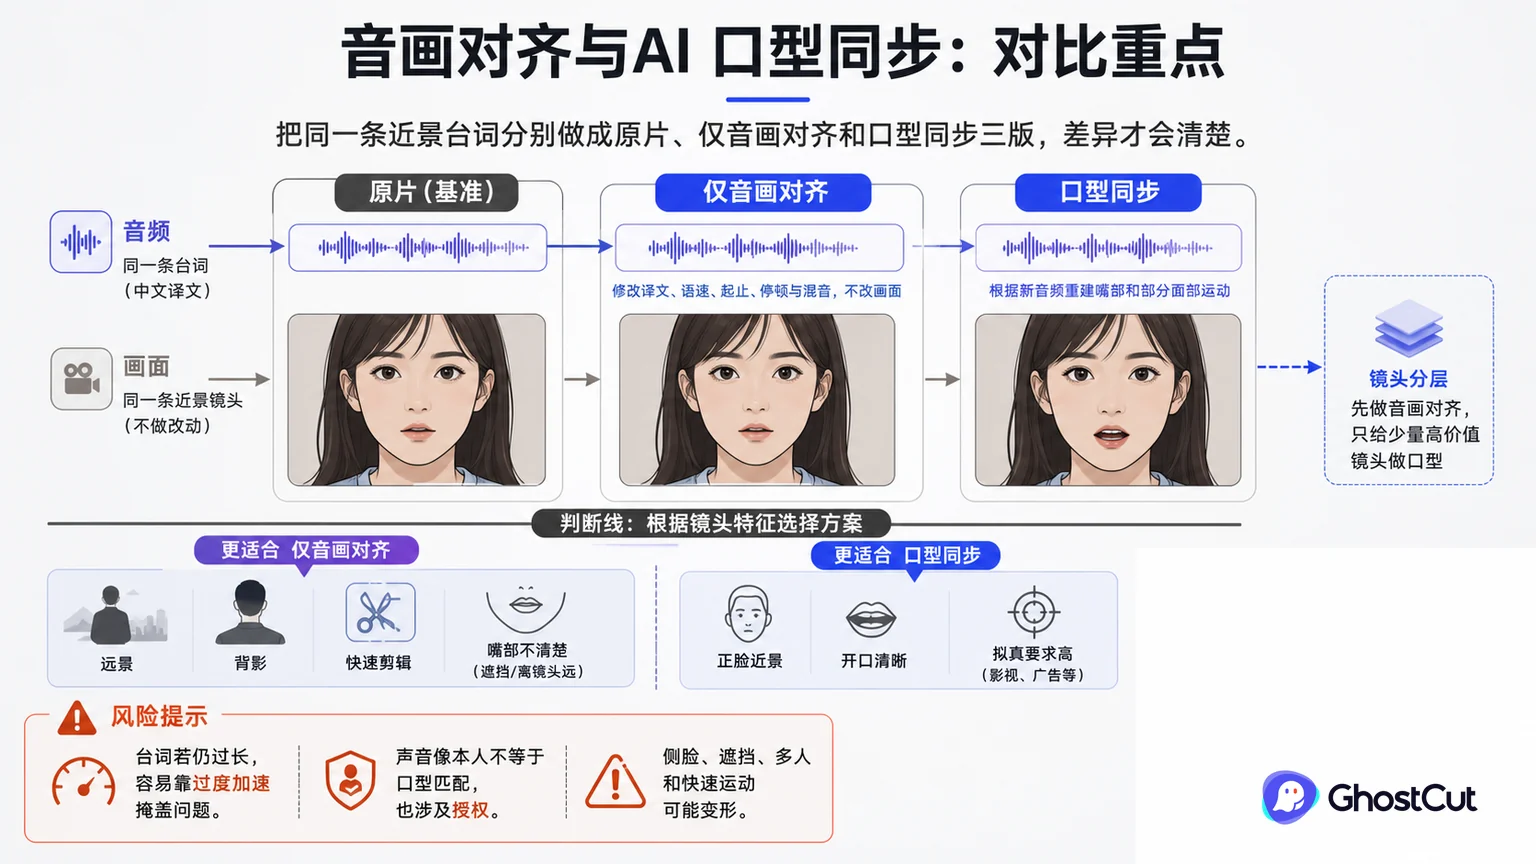
把同一条近景台词分别做成原片、仅音画对齐和口型同步三版,差异才会清楚。不是所有镜头都值得进入第三版。
| 路线 | 实际处理 | 更适合的镜头 | 主要风险 |
|---|---|---|---|
| 仅音画对齐 | 修改译文、语速、起止、停顿与混音,不改画面 | 远景、背影、快速剪辑、嘴部不清楚 | 台词若仍过长,容易靠过度加速掩盖问题 |
| 声音克隆+对齐 | 保留说话人音色,再把新音频落入时间窗 | 访谈、口播和角色辨识重要的内容 | 声音像本人不等于口型匹配,也涉及授权 |
| AI 口型同步 | 根据新音频重建嘴部和部分面部运动 | 正脸近景、开口清晰、拟真要求高 | 侧脸、遮挡、多人和快速运动可能变形 |
| 镜头分层 | 整剧先完成音画对齐,只给少量高价值镜头做口型 | 大多数商业短剧 | 需要先标镜头风险和统一验收标准 |
选择并不一定只有一个答案。已有开发团队和媒体管线的公司,可以把成熟 API 接进自己的队列;偶尔处理一条视频的创作者,更在意打开网页就能完成;而连续发行多部短剧的团队,通常更需要剧集、角色、术语和多语言版本长期留在同一套生产流程里。
先固定配音,再比较同镜头画面
选择正脸近景、侧脸、遮挡、多人切换和快速运动片段。原片保留作画面参考;仅音画对齐版与口型版使用同一份已定稿目标语音频,才能看清嘴部处理增加了什么。若候选产品只能在内部生成配音,应另记为完整翻译流程比较,不能把声音变化算作口型算法的收益。检查牙齿闪动、下巴变形、遮挡穿帮与镜头衔接,失败镜头回退到不改画面的版本。
使用步骤
代表任务不需要很长,但要包含真实项目里最费时间的部分,例如多人抢话、前后称谓变化、移动背景上的硬字幕、需要重配的一句台词,以及同一内容的两种交付规格。这样跑一轮,团队很快就会知道瓶颈落在模型、操作还是交接上。
结论:按输入、规模和交付要求选择
默认路线应从音画对齐开始。只有当观众确实能看到嘴部、声音已经稳定、修改接近结束,而且口型不一致会明显影响发布目标时,才把镜头送进视觉生成。
一句译文改短后,配音和口型都可能需要重做,因此应先把声音定下来。GhostCut 按剧集连接角色、翻译、配音与合成,便于围绕对应台词处理前置修改,再把确认的音频和镜头交给口型工具。它在这组方案中的长处是整剧制作衔接;只做一条正脸口播时,直接在 HeyGen 或 Rask 跑完视频翻译与口型流程可能更方便。
当声音和镜头路线确定以后,团队还会遇到另一个容易混淆的问题:有 TTS、有剪辑工具,并不等于已经有一套能理解剧情、保留名场面并输出成片的自动解说系统。