关掉字幕后还看得见字吗?先判断文字在哪一层
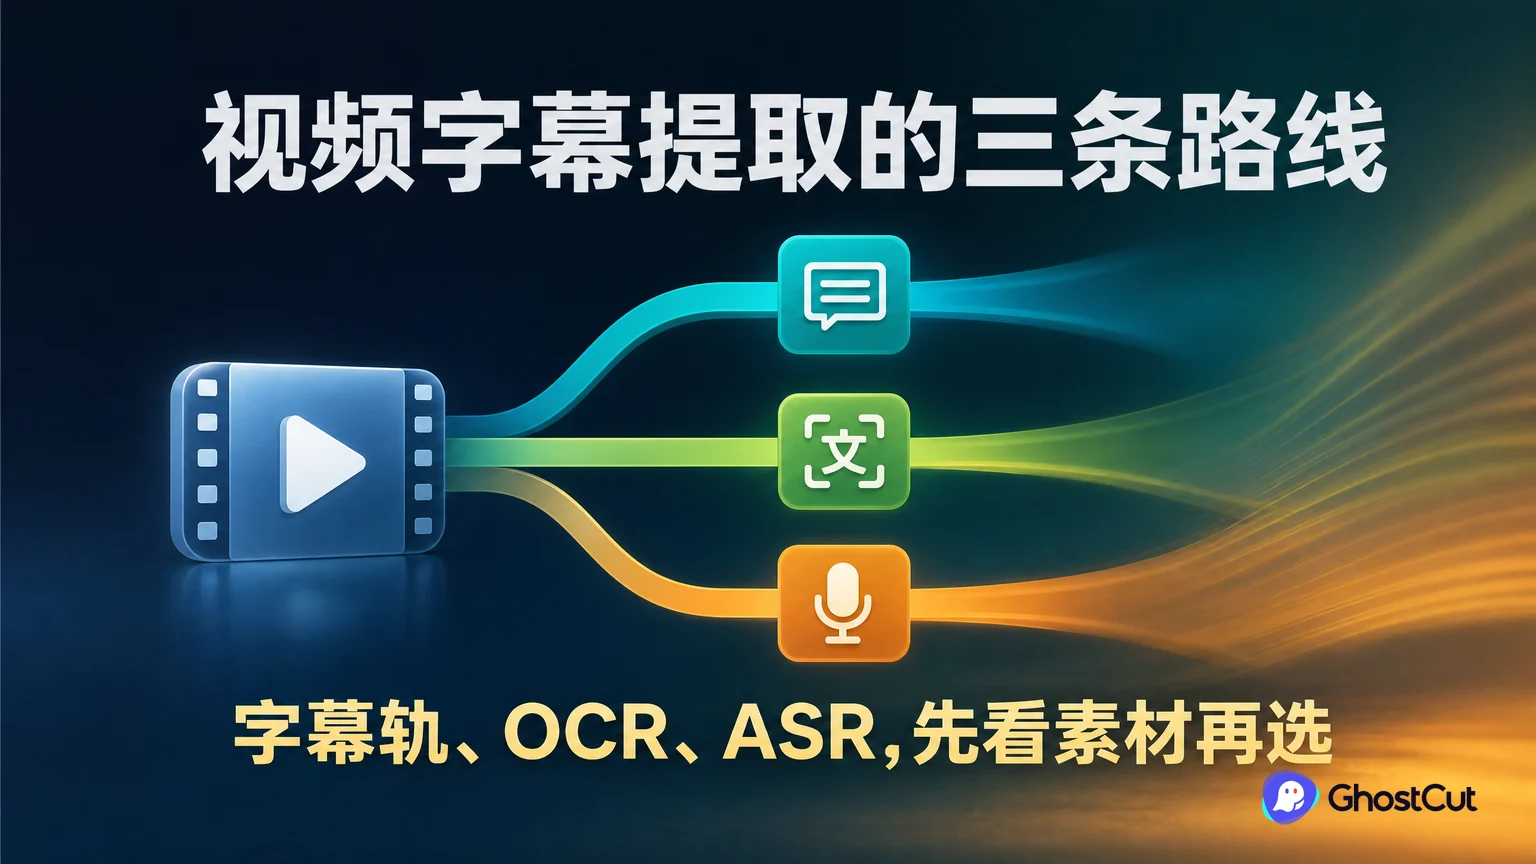
收到 MP4 或 MKV 后,先在播放器关闭字幕。仍留在画面里的字属于硬字幕;随开关消失的字可能来自内嵌字幕轨,也可能来自同目录的外挂文件。打开播放器的轨道信息,查清来源和语言,别因为扩展名相同就认为整批素材都有相同字幕。
有 FFmpeg 工具时,可运行 ffprobe -v error -show_streams -of json input.mkv,检查 codec_type 为 subtitle 的流、编码名称和语言标签。没有字幕流但目录里有 SRT,就先导入核对;既无文件又无字幕流,才进入 OCR 或 ASR。下面命令中的文件名和流序号都是示例。
文本字幕轨直接导出,位图字幕轨还要识别
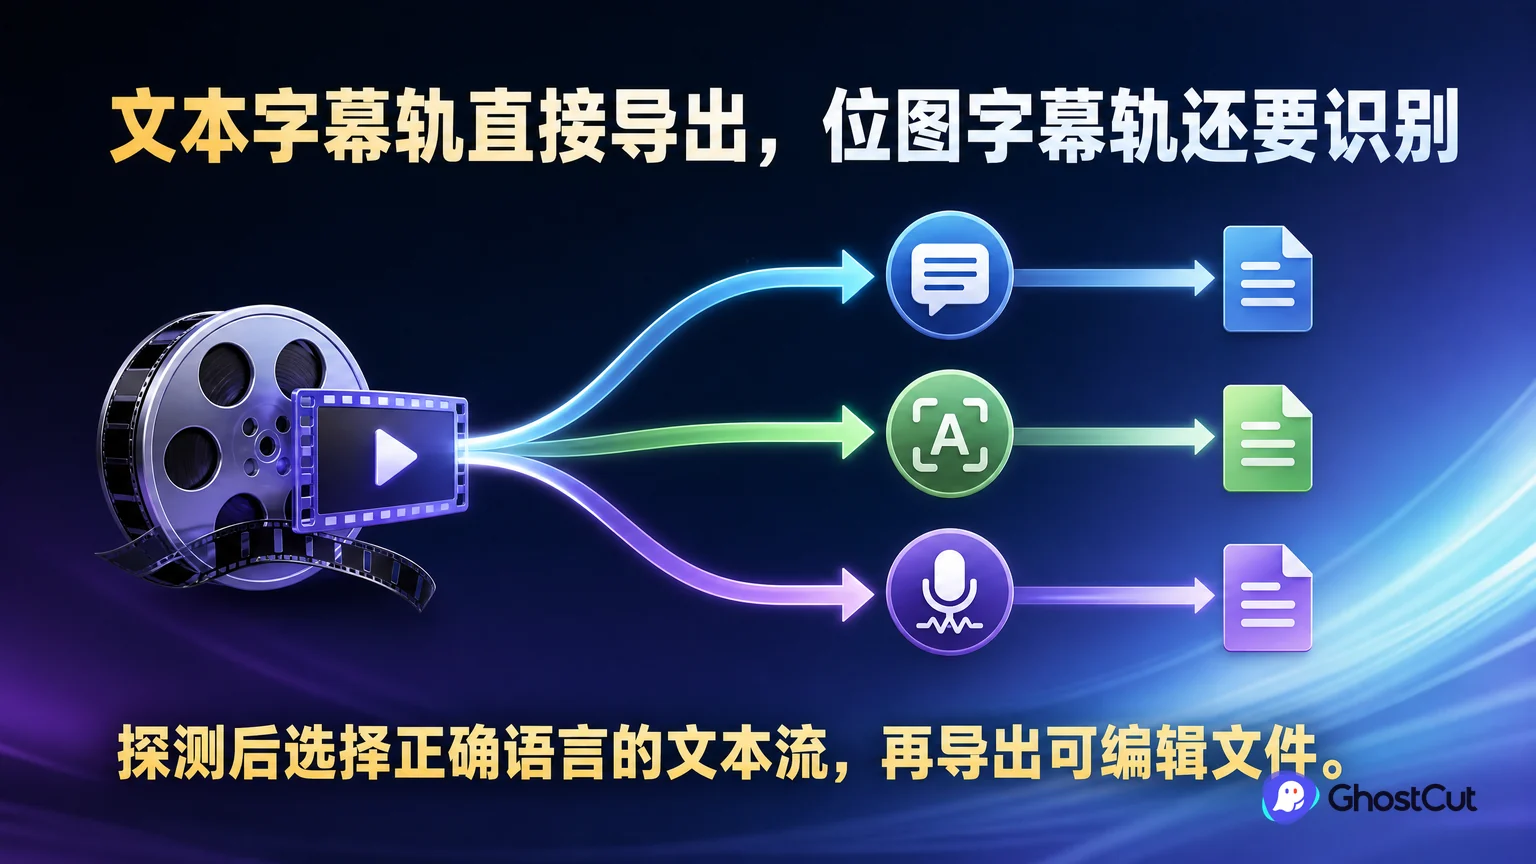
探测后选择正确语言的文本流,再导出可编辑文件。例如确认第一条字幕流就是所需台词时,可运行 ffmpeg -i input.mkv -map 0:s:0 -c:s srt extracted.srt。这里 0:s:0 指第一个输入中的第一条字幕流,不是所有素材都应选择的固定序号。
导出前检查编码类型。ASS 转为 SRT 会丢失部分排版、样式和特效,应保留原 ASS;PGS 等位图字幕存的是图片,不能靠这条命令直接变成文字,需要用支持位图字幕的 OCR 工具识别。若选中的是注释轨或只有少量外语对白的强制字幕轨,导出会成功但内容不完整,所以仍要对照全片。
打开结果检查中文是否乱码、第一句与末句是否齐全,再放回原视频看同步。已有文本只出现个别错字时直接修文本,比重新识别全部对白更可控。
硬字幕走 OCR:先识别对白区,再合并时间相邻的文字
光学字符识别(OCR)读取画面里的字。先取普通对白、双行字幕、快速切镜和人物遮挡的片段,确认字幕位置是否稳定,再指定对白区域与语言。人物卡、广告、水印和手机消息另列用途;全屏识别会把这些内容混入台词,后面翻译也会跟着混乱。
识别后把连续帧里同一句话合并为一个字幕条目,并保留出现与消失时间。两句只差一个字时不要自动当成重复,例如“不是他”和“就是他”可能正是反转。若某几集字幕上移,只调整这些集的区域;画质过低时改用清晰原声辅助,不要先放大整批再指望文字自然变准。
OCR 必须读取还保留原字的素材。净版可以另外制作,但源片与 OCR 结果要留下,之后漏句或时间边界有争议时仍能回看。
无字幕走 ASR:先选对白轨,再补人名与抢话
自动语音识别(ASR)从声音建立台词和时间信息。先试听各音轨,选实际包含源语言对白的版本;有独立对白轨时优先比较其清晰度。不要把配乐轨、其他语言配音或左右声道缺失的文件直接送去识别。设置源语言后,用耳语、争吵、画外音和音乐强的片段试跑。
得到初稿后,跟着视频补专名、数字、漏掉的短促回答和多人重叠。识别出的说话人编号只代表声音分组,需要回看角色才能确认姓名。静音或纯音乐片段出现完整句子时,检查是否为误识别,不应因为句子通顺就保留。
若需要降噪或分离人声,先对照处理前后的样片。处理过强可能让尾音和轻声一起消失,导致漏词;这种情况回到原声人工补写,比在损伤后的音轨上不断重试更直接。
OCR 和 ASR 对不上时,先分清字幕稿与实际说话
画面字幕有时省略语气词,原声却完整说出;手机消息则有文字但没有人念。两路结果不同不一定是谁识别错了。先确定交付是对白字幕、无障碍字幕还是画面文字翻译,再决定哪些内容应保留,不能简单把两份结果拼接起来。
| 差异 | 回看什么 | 处理方式 |
|---|---|---|
| 名字写法不同 | 首次出场人物卡与后续称呼 | 确认标准名字,再查全剧变体 |
| 有声音但画面无字 | 画外音、插话和片尾对白 | 按交付用途补字幕,不照抄 OCR 空白 |
| 有文字但没有对白 | 聊天消息、路牌或包装文字 | 记录为画面信息,避免塞进角色配音 |
保留每条修订的来源说明,尤其是金额、身份和关键否定词。两路都不清楚时标记待补源或人工确认,别用前后剧情猜一个“看起来合理”的句子作为定稿。
校轴时区分整体偏移、逐渐漂移和单句入点错误
把字幕加载到最终要用的视频,分别对开头、中间、结尾。全片都早了相近时长,可整体平移后复查;越到后面差得越多,要检查视频版本、帧率处理或中途删减;只有个别句子不准,则局部改入点与出点。不能用一次整体平移掩盖每段剪辑造成的不同偏差。
接着按语义断句,检查字幕是否闪得太快、跨到下一人说话或盖住关键画面。合法的重叠对白与重复台词不能一概删除。正常速度从头到尾看一遍关键段落,确认文字不仅“识别对了”,也确实来得及读完。
交出匹配母版的字幕,同时留下识别原稿
导出后重新打开 SRT 或接收方指定格式,检查编码、时间顺序、结束时间大于开始时间,以及是否超出视频时长。保留原始字幕轨或识别稿、人工批准稿和对应视频版本;不要让后续翻译人员误把未校对的 OCR 结果当成标准台词。
需要批量处理多集时,GhostCut 的 ASR 与 OCR 可把不同素材转成可编辑字幕,校对后的 SRT 再进入翻译。已有准确字幕轨的素材仍直接复用。提取完成后最常见的下一步是修时间与阅读负荷,可接着看字幕翻译怎样控制 CPS,把可编辑稿变成观众能读完的字幕。