光学字符识别/01
读取画面中已经编辑好的对白字幕
适用于画面中已经内嵌硬字幕或其他明确对白文字的视频。真正的难点,是把跨帧重复出现的文字合并成稳定字幕条,同时排除招牌、手机界面等场景文字。
- 自动定位字幕区域和出现时间
- 跨帧识别与字幕条合并
- 场景文字过滤与谨慎纠错
字幕生成技术
错提、漏句、断句怪、时间轴飘,后面翻译和配音都会一起跟着返工。鬼手剪辑会先看素材:画面上有清晰硬字幕就走视频 OCR,只有声音就走字幕型 ASR;再合并重复帧、去掉招牌等场景字,断句打轴后给出可编辑 SRT。每天约 30 万+集短剧译制任务,都在这条链路上跑。
你能原谅爸爸吗?
一帧画面可能同时包含多类可读文字,只有对白应该进入字幕时间轴。
本地化质量
很多看似发生在翻译或配音环节的问题,其实源头是字幕识别:错词、漏句、不合理的字幕条边界或说话人切换错误,都会继续传递到下游。可靠的源字幕时间轴,才能支撑 基于剧集上下文的字幕翻译 ,并进一步支持 角色化 AI 配音与声画同步.
同一部短剧实测
鬼手剪辑以人工审核字幕作为参考答案,在同一部短剧、同一时间轴口径下,对硬字幕 OCR 与纯音频 ASR 基线进行了对照评测。
即使允许一定的时间边界误差,两条路径在字幕条级别仍有明显差距。对译制团队而言,这意味着更少的错切、漏句和逐条返工,也意味着翻译与配音能从更可靠的源字幕开始。
选择更强的来源
画面已有可靠硬字幕时,使用视频 OCR; 只有音频对白、没有可用硬字幕时,使用 ASR。
短剧里的 BGM、音效、口音、哭喊、耳语、多人重叠对白和高度口语化台词,都会干扰语音识别。如果画面中已有准确的内嵌字幕,它通常比混合音轨更清楚地表达原始台词。
适用于画面中已经内嵌硬字幕或其他明确对白文字的视频。真正的难点,是把跨帧重复出现的文字合并成稳定字幕条,同时排除招牌、手机界面等场景文字。
当对白只存在于音轨中时,应使用 ASR。识别出文字只是第一步;合理断句、时间边界、单条长度和说话人切换,才决定结果能否直接用于字幕渲染。
视频OCR
30 fps 的一分钟视频包含 1,800 帧。若逐帧独立运行通用 OCR,不仅计算重复,还会得到大量重复文字框。视频字幕系统必须把这些帧级结果合并成有起止时间的字幕条。
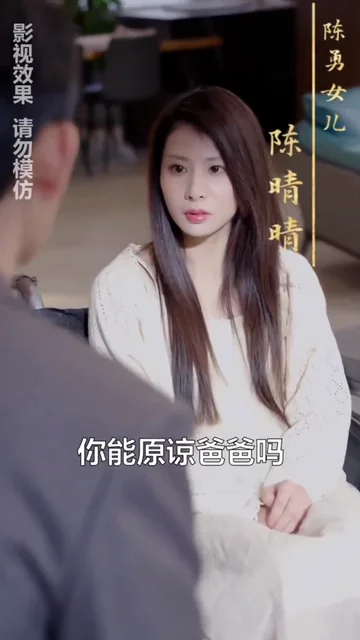 第 15 帧00.50秒
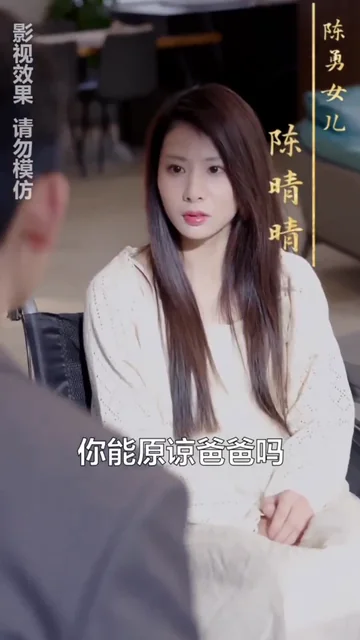 第 20 帧00.65秒
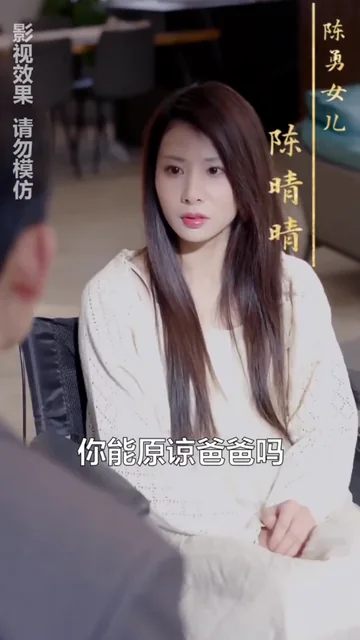 第 24 帧00.80秒
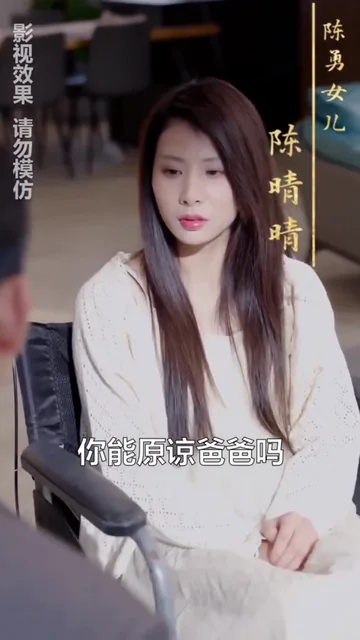 第 29 帧00.95秒
00:00:00,420 --> 00:00:02,260
你能原谅爸爸吗?
在字幕区域或全画面中,查找可能属于对白字幕的文字。
结合文字内容、位置和持续时间,将相邻帧的重复结果合并成稳定字幕条。
过滤无关场景文字,并在不臆造台词的前提下修正明显识别噪声。
合并重复片段,确定字幕条的开始与结束时间,并导出可编辑 SRT。
误检对照
画面里可能同时出现招牌、手机界面、商品标签、Logo、名片、提示语和营销贴片。字幕文件应只保留对白,不能把画面中所有可读文字都写进时间轴。
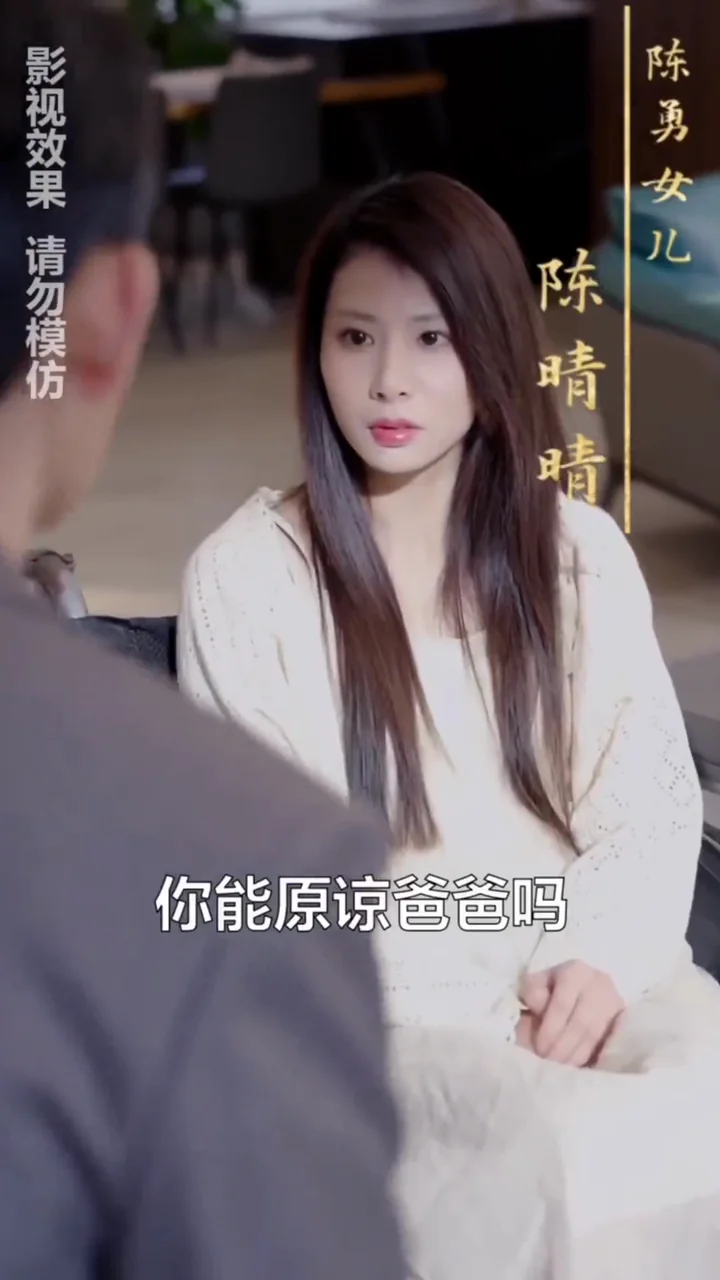
台词属于定时字幕轨道。
长期固定的声明或制作信息不是对白。
人物介绍等身份文字不应进入对白时间轴。
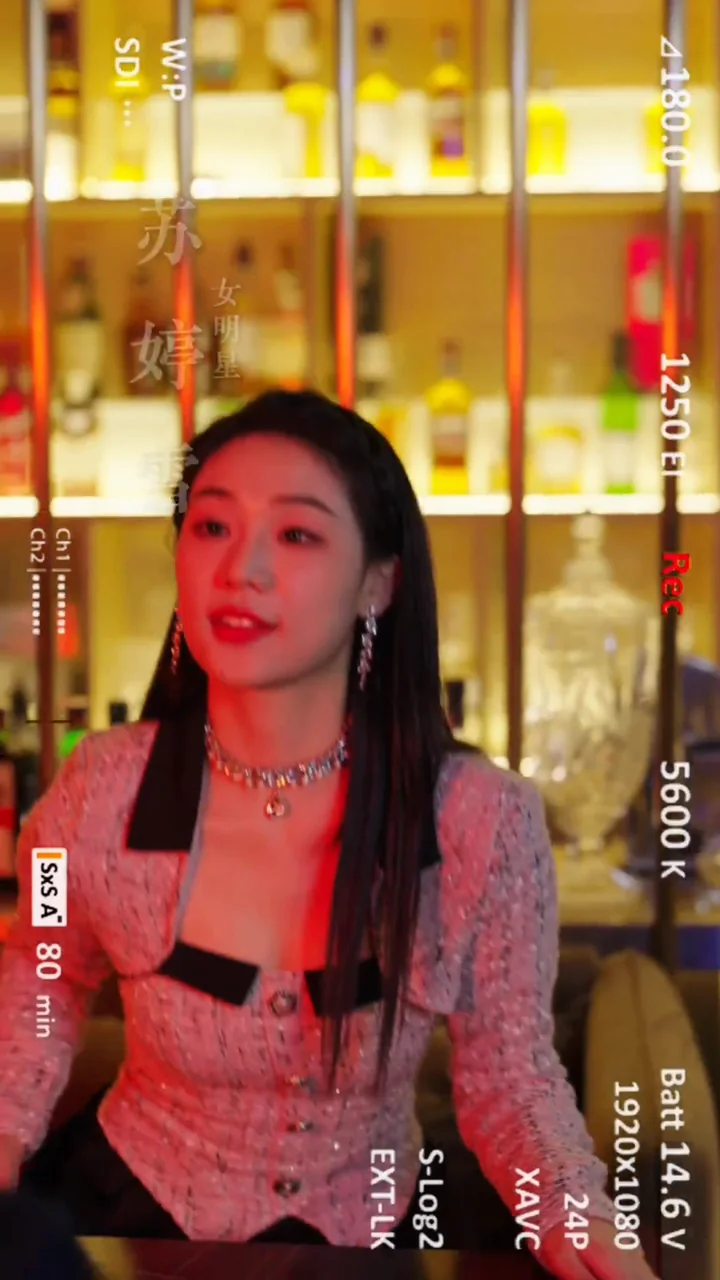
参数、比例和设备界面文字仍属于画面内容。
视频 OCR 必须先判断文字类型,才能生成干净、可用的字幕文件。
字幕型 ASR
传统 ASR 的目标是把语音转成文字;字幕型 ASR 还要完成打轴与断句,把连续词流切分成简洁、可读的字幕条,并综合语义、停顿、说话人切换和屏幕承载能力。
播放器不能直接渲染一整段转写文本。字幕必须有清晰的条级边界,每次说话人切换也要准确可辨。
不能把一整段文字
一个直接交给播放器。
一个字幕需要可读的边界,
乙说话人切换也必须清晰。
乙开源只是起点
开源技术为字幕识别提供了良好起点。PP-OCRv5 在本页所列多语种公开数据集中的最高识别准确率为 94.20%;鬼手剪辑在自有短剧字幕验证集上的 OCR 字符准确率达到 98.25%。二者数据集与任务定义不同,不能直接视为端到端视频字幕准确率对比;在各自口径下数值相差约 4.05 个百分点。真正决定交付质量的,仍是在同一批视频、同一参考字幕和同一字幕条口径下,持续减少错提、漏句与时间轴偏差。
这是特定多语言文字数据集上的识别准确率,用来说明语种和文字体系会显著影响结果。它不是视频跨帧检测、字幕合并、场景文字过滤和时间轴生成的端到端准确率。
阅读 PaddleOCR 评测说明Whisper large-v2 是 OpenAI 发布的语音识别模型。论文中,WER 从 LibriSpeech 干净语音的 2.7% 变化到 CHiME-6 噪声语音的 25.5% 和 AMI 远场语音的 36.4%,说明收音环境会显著改变 ASR 结果。这不是短剧场景的平均 WER。
阅读 Whisper 论文返工成本
面对上百集短剧,低错误率意味着运营只需抽检和处理少量异常;错误一旦密集,团队就不得不逐条复核,字幕校正很快会成为整个译制流程的瓶颈。
每修正一处错误,都要定位字幕条、回放上下文、确认原话、修改并再次检查。当错误过多时,运营会失去对结果的信任,最终退化为全量逐条审校。
生产交付
识别准确只是起点。规模化生产还需要批次管理、任务状态、可编辑结果、回调机制,以及向翻译和 AI 配音环节的顺畅流转。
批量上传剧集,按素材情况选择 OCR 或 ASR,并在同一工作区中沉淀可复用的系列项目。
了解译制出海工作流程查看任务状态、打开已完成的结果、下载可编辑的 SRT,然后继续进行翻译或配音。
阅读生成指南提交 OCR 或 ASR 任务并保留项目与任务 ID,再通过轮询或回调接入企业自己的媒体生产流程。
阅读 API 参考把画面里的字,或音频里的对白,整理成一条条带时间轴的字幕。可用的结果通常包括文本、起止时间、合理断句和语种信息,并导出成 SRT 这类可编辑格式。
先判断走 OCR 还是 ASR,再合并重复帧、过滤场景字、断句打轴,输出能直接进翻译和配音的 SRT——而不是只有一段转写稿。
约 80% 的头部出海 AI 短剧客户和服务商在用鬼手剪辑。团队每天处理近 30 万+集短剧译制(大约 3,000+ 部)。在不少客户项目里,译制成本大约降 80%,收入规模也有约 10 倍增长——具体仍看题材、语种和发行节奏。在自有短剧数据集上,OCR 字符准确率 98.25%,严格字幕条精确召回率 98.92%。交付是可编辑 SRT;硬字幕清楚时优先 OCR,只有音频对白时走 ASR,默认不会混成一路糊弄过去。
烧录字幕还算清楚的短剧或漫剧;手里没有字幕文件、只能从音频出轴;以及后面还要翻译、配音、人工审校的生产前置。
画面糊成一团、压缩伪影很重又没法补刀的素材;或者你要的是逐帧艺术字、特效字幕创意设计,而不是生产用对白轴。
把角标、人物卡、免责声明一并提进对白轴;用普通转写结果当字幕条,不管断句和阅读速度;OCR 和 ASR 混用后,关键对白没再人工对一下。
可以。视频 OCR 能识别烧录在画面中的文字,跨帧合并重复结果,估算字幕条的起止时间,过滤无关场景文字,并导出带时间轴的字幕。
当画面中的硬字幕可靠时,OCR 直接读取已经编辑好的文字,不容易受到 BGM、音效、口音、哭喊、耳语和重叠对白干扰。
转写结果可能是一整段文字,也可能断句和阅读速度不适合上屏。字幕型 ASR 必须输出简洁的定时字幕条,并正确处理语义边界和说话人切换。
不会默认把两者混合。OCR 与 ASR 是两条独立的字幕生成路径,团队可根据素材情况选择,并在审校时对照结果。
先建立可靠的源字幕时间轴
有可靠硬字幕时选择视频 OCR,只有音频对白时选择字幕型 ASR。审校 SRT 后,再继续翻译、AI 配音和成片导出。
从 鬼手剪辑开始AI 短剧 · 短剧出海
继续了解鬼手剪辑如何把字幕生成、模型评测、翻译、画面修复、AI 配音和系列化生产连接起来,并将验证过的流程扩展到更多剧集与目标语言。